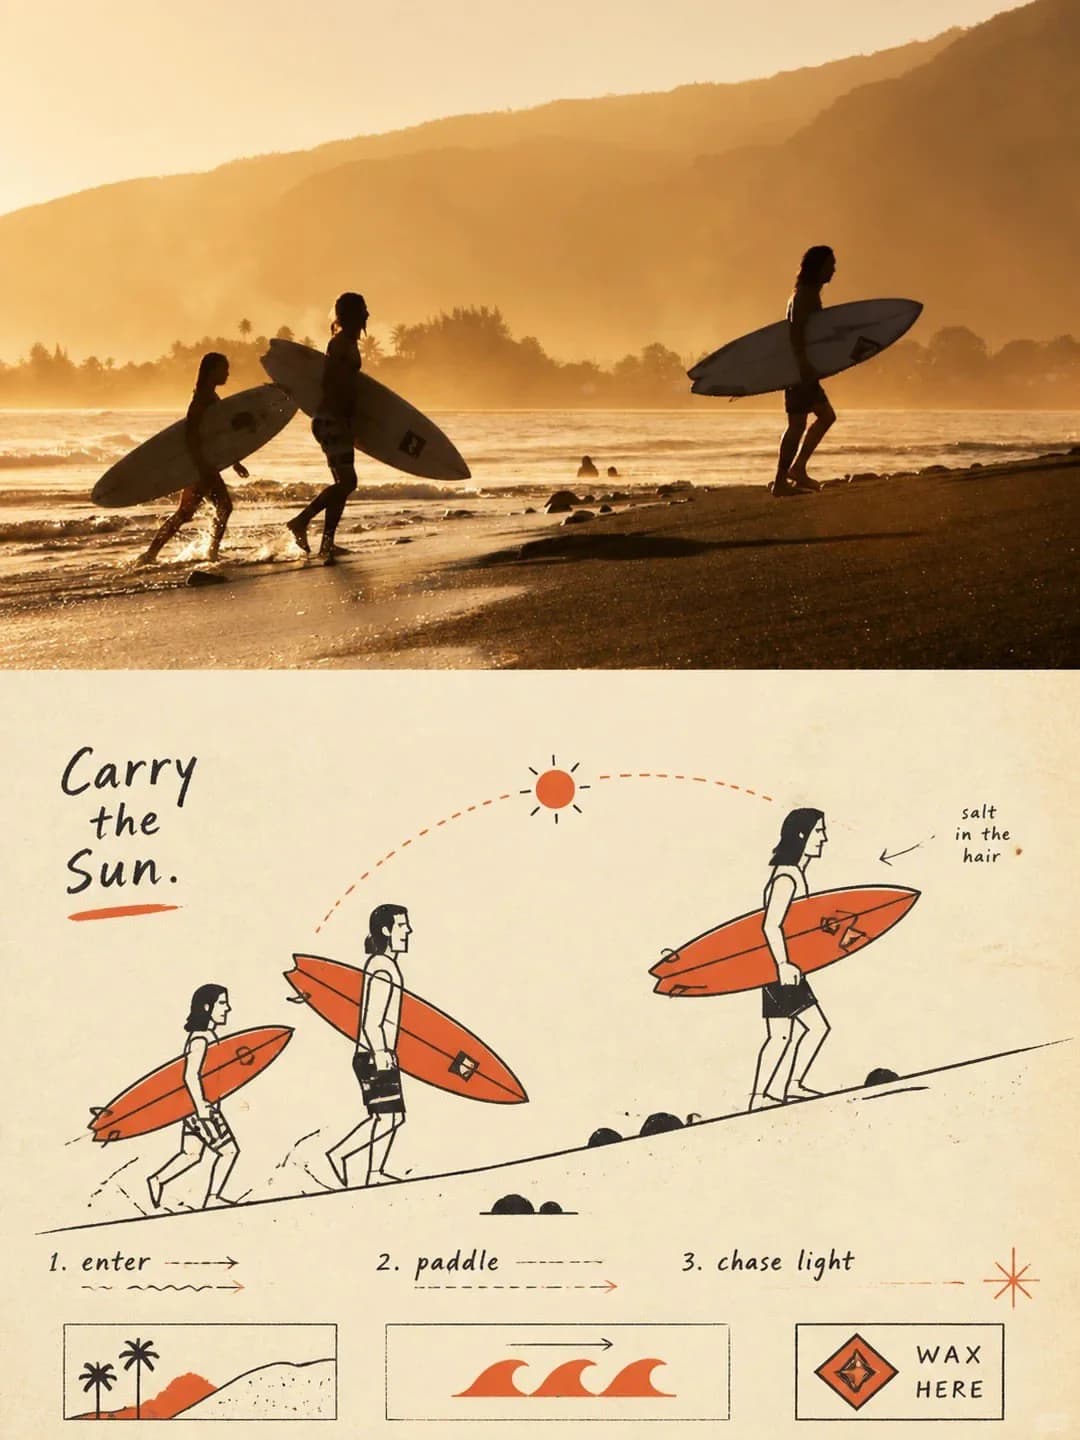
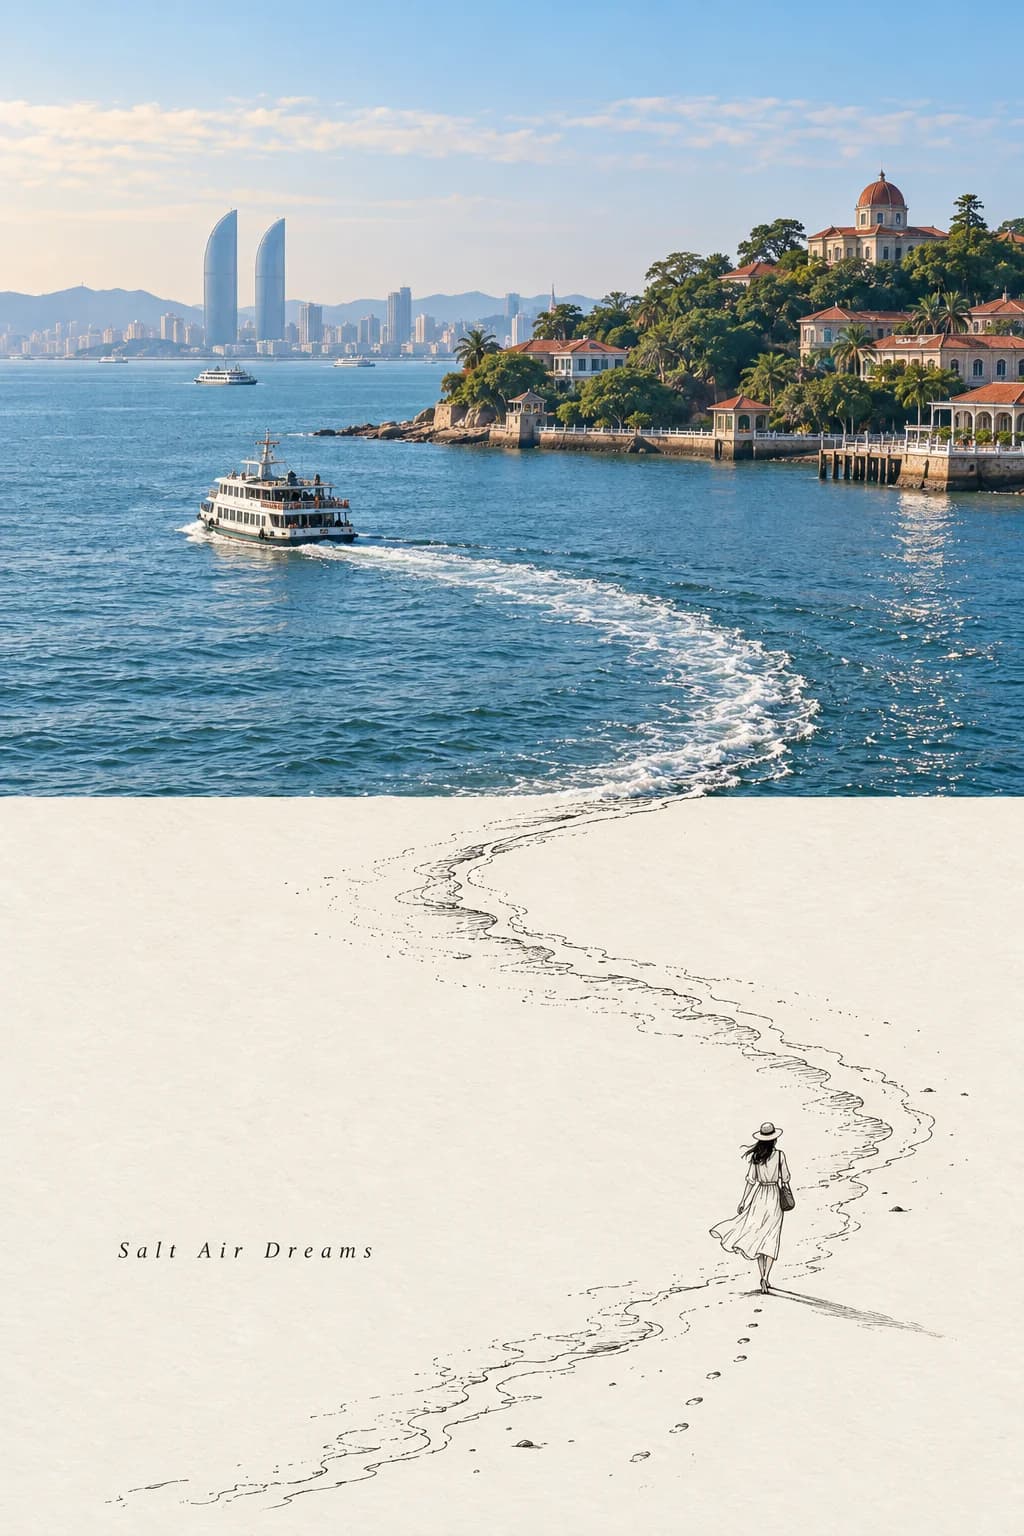
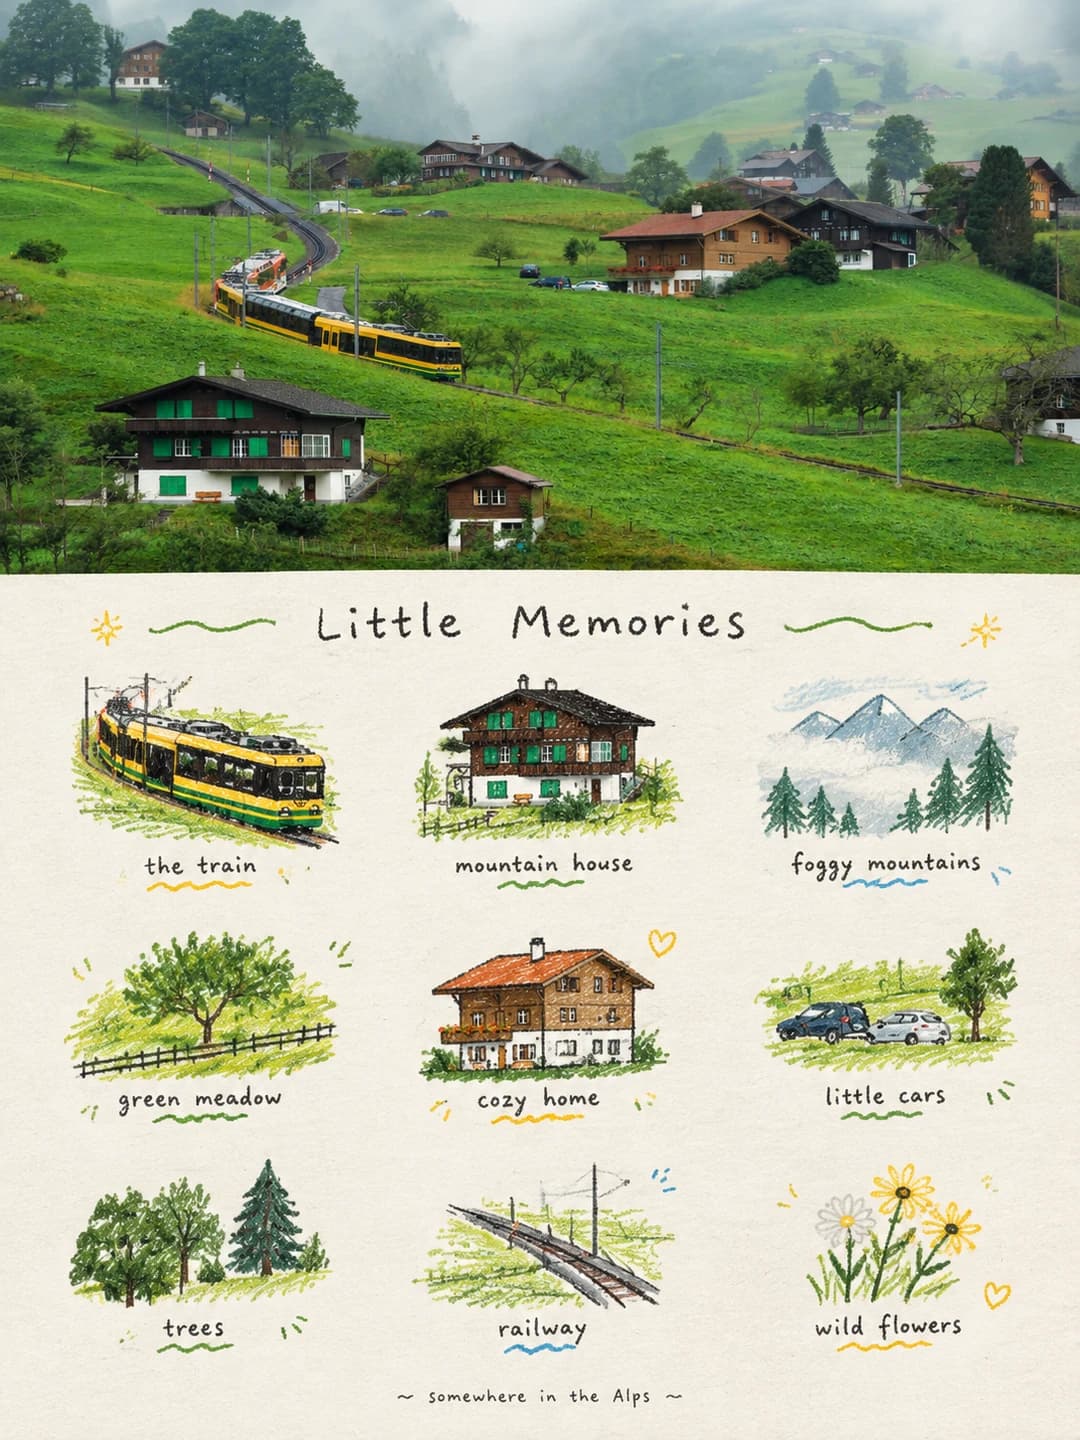
コンセプトマップ・アートポスター
上に写真、下にその意味を解き明かすスケッチ風の図解を
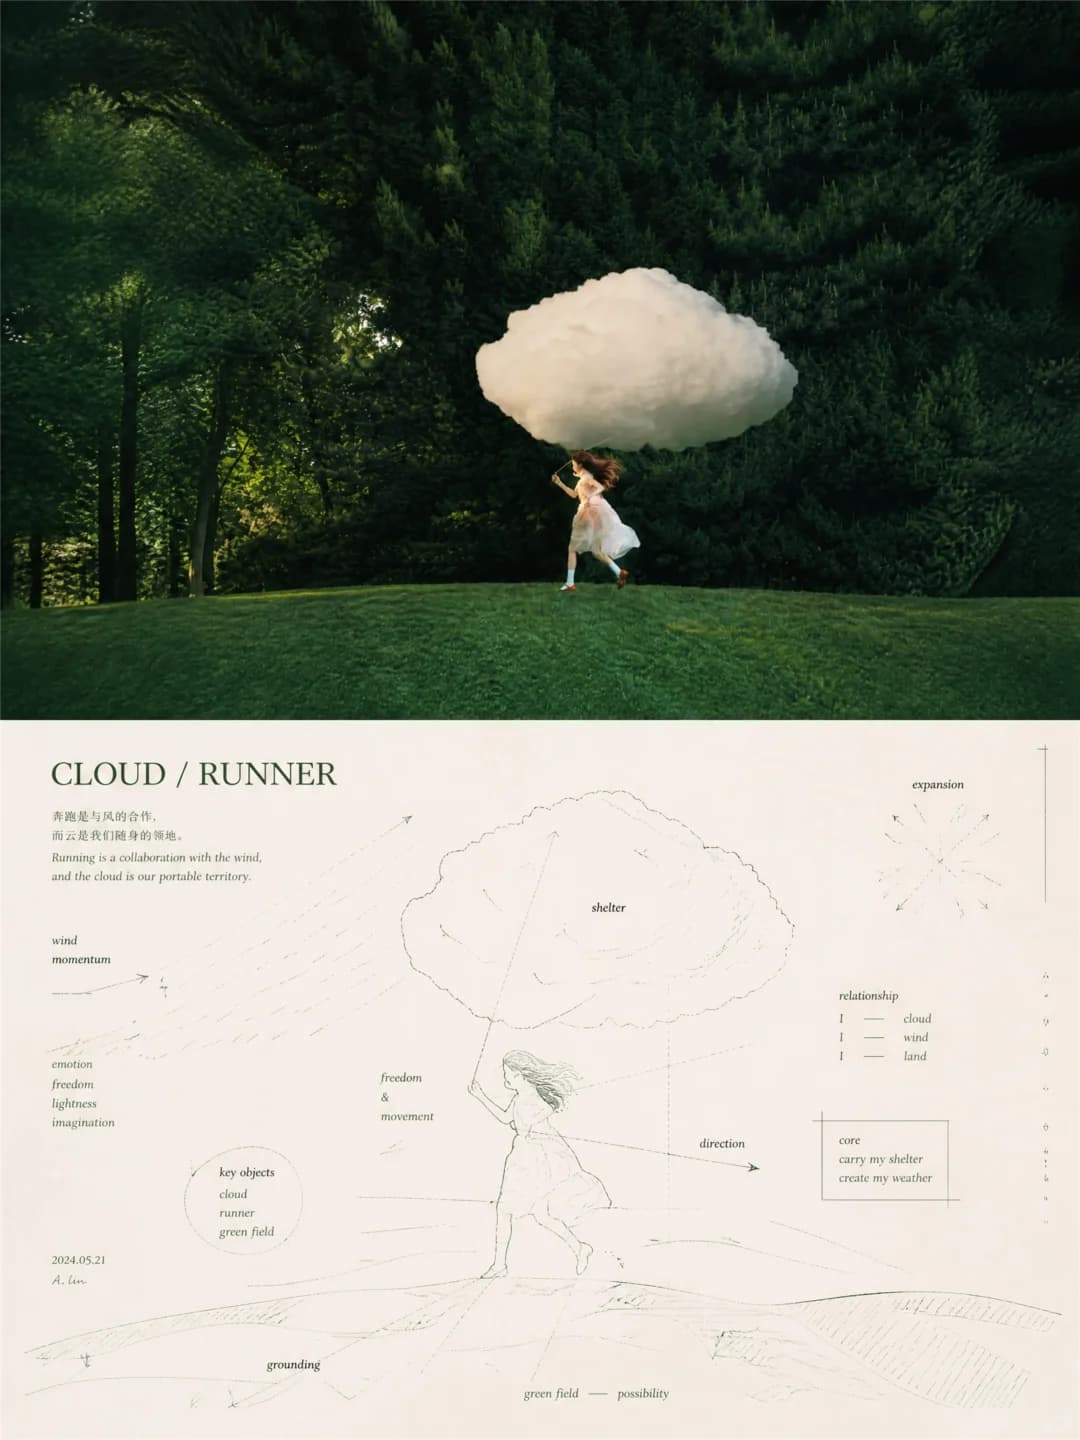
写真をアップロードすると、3:4のポスターが生成されます。上半分はあなたの写真、下半分は同じ被写体をラベル、ノード、矢印、軸、手書きの記号へと分解したものです。思考の断片がそのまま一枚の絵になったような、知的なデザインに仕上がります。
画像1枚あたり100クレジット · 約1分 · 新規アカウント登録で500クレジット — 無料画像5枚分。
あなたの写真を試す
新規アカウント登録で500クレジット — 無料画像5枚分。
例
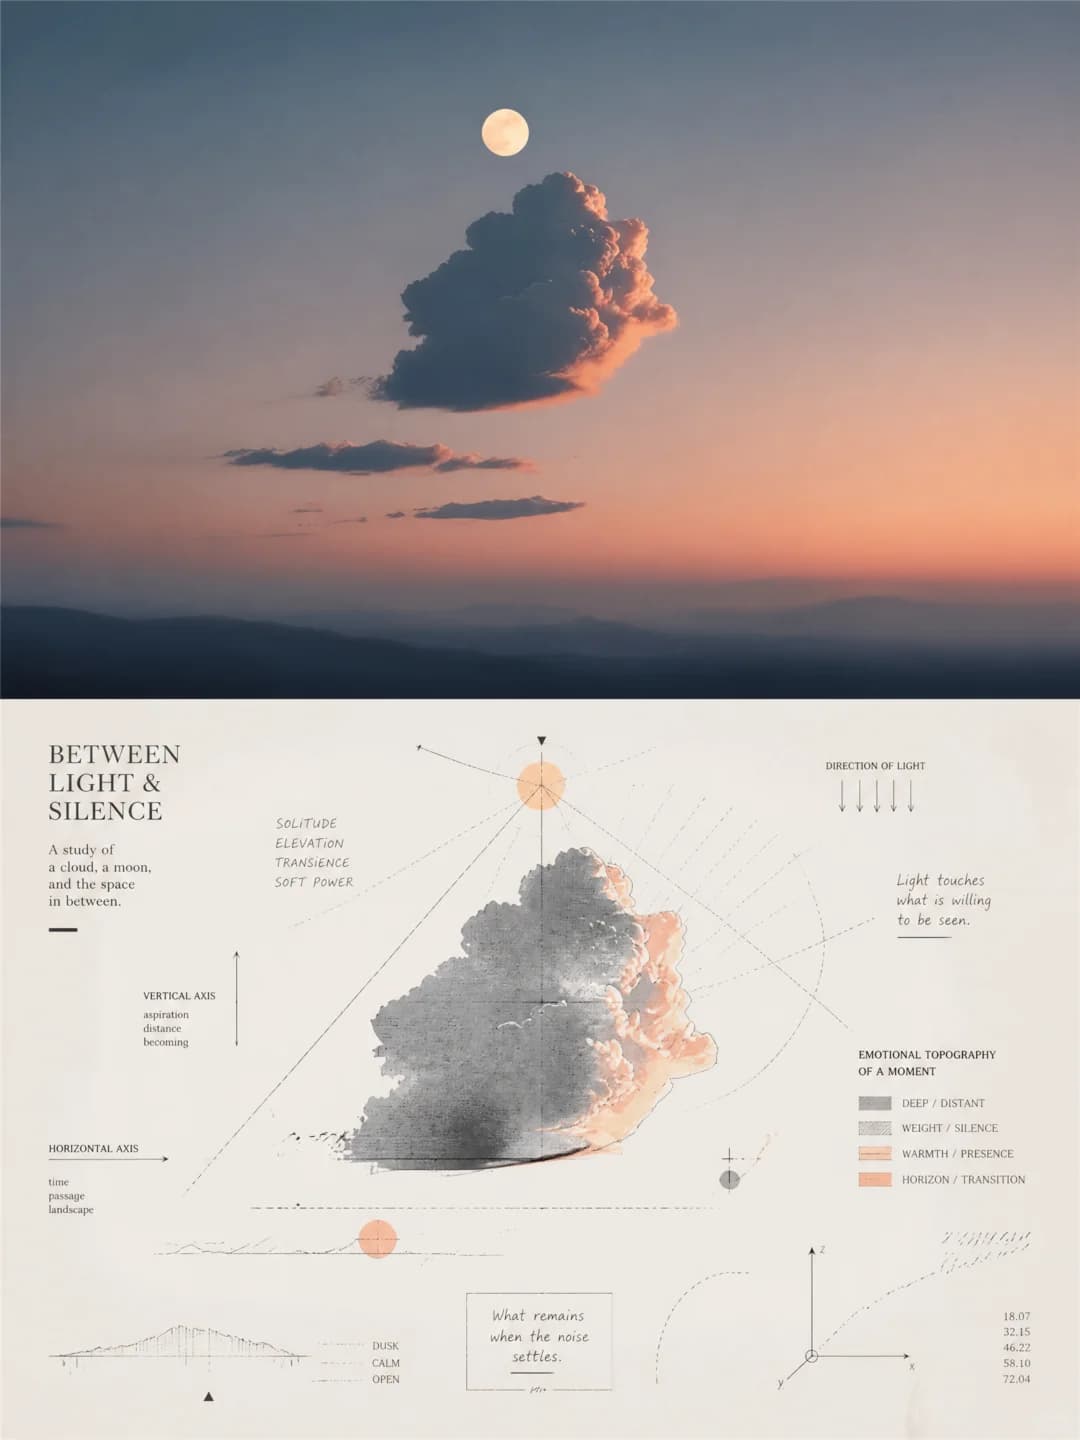
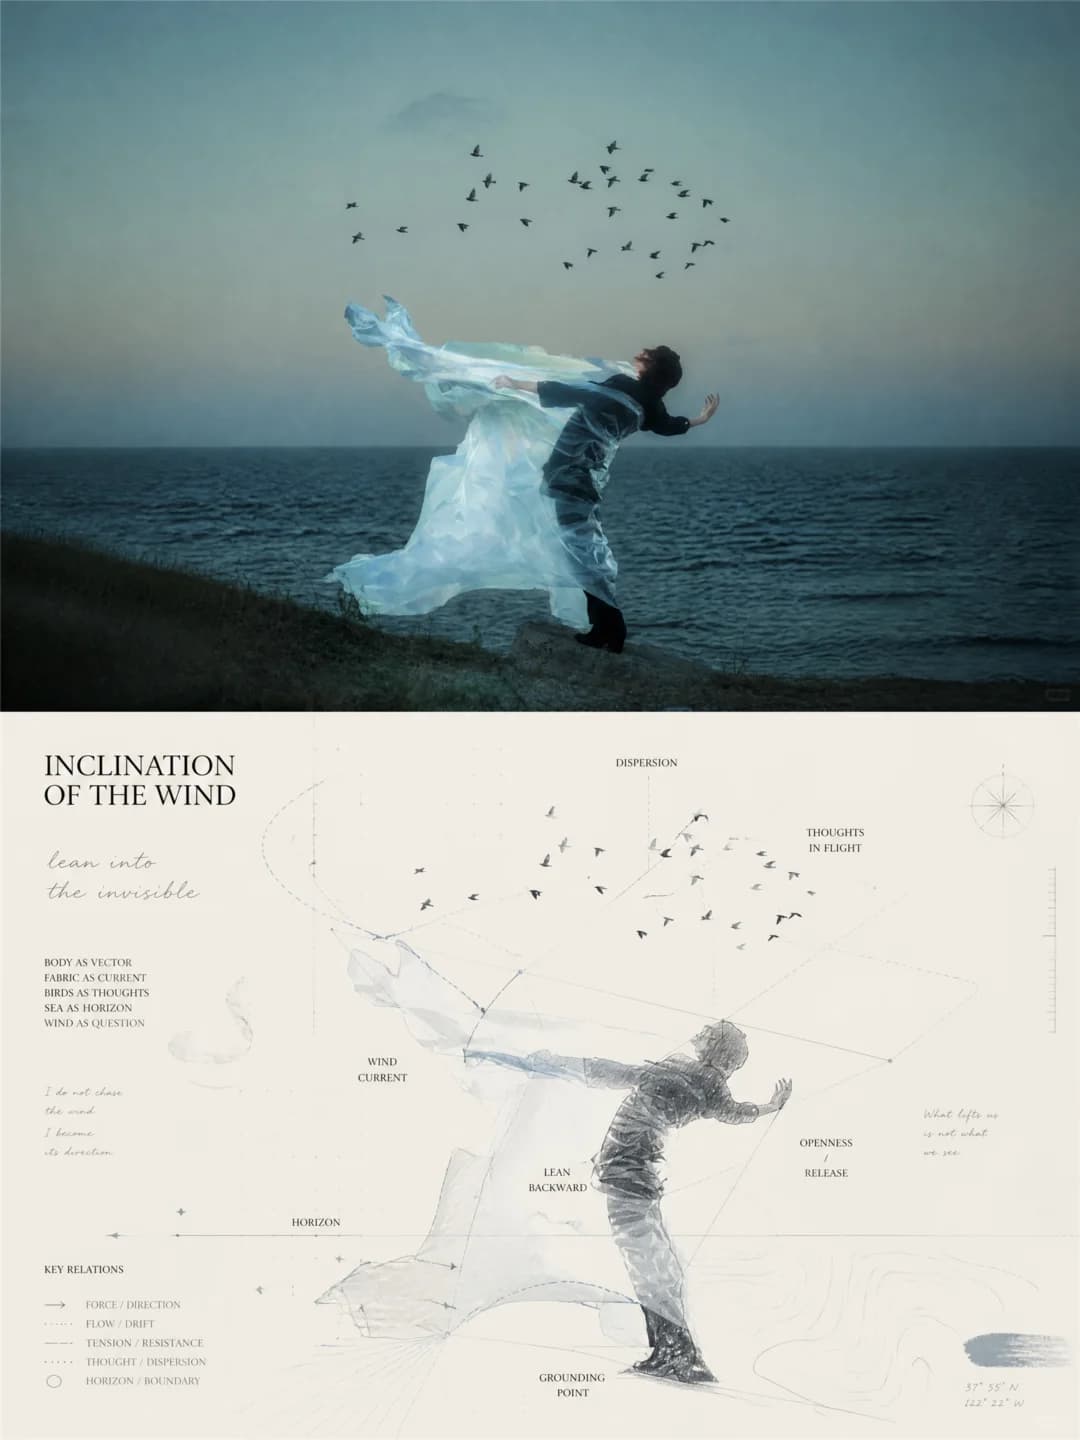
下記の画像はすべて、このページのプロンプトを使用して作成されました。
コンセプトマップ・アートポスターとは?
コンセプトマップ・アートポスターは、画面を上下に二分した3:4の垂直レイアウトが特徴です。上半分には、軽く色調補正(グレーディング)を施した元の写真が配置されます。下半分は、元のシーンをそのまま写すのではなく、被写体の輪郭やポーズ、方向性をかすかな幾何学的骨組みとして抽出し、その上に図解を重ねます。被写体の意味を指し示す短い単語、ノードと結線、矢印、交差する軸、ボックスで囲まれた選択範囲、等高線のような曲線、チェックマーク、そして手書きのメモ。これらが余白を活かした淡い背景の上に描かれ、図面とノート、そしてアートの中間のような独特の質感を表現します。
どんな写真が向いている?
被写体が明確で、動きや情緒がはっきりしている写真に適しています。例えば、風に向かって走る人、夕暮れの空に浮かぶ一つの雲や月、飛んでいる鳥、一本の木、海を背にした人物など。横長の写真の方が上半分の枠に収まりやすく、背景がすっきりした静かな写真ほど、下半分の図解や余白、文字が引き立ちます。
どんな写真が苦手?
中心となる被写体が不明確で、多くの要素が混在するシーンには適していません。また、すべてのラベルに正確さが求められる用途にも不向きです。テキストはモデルによって生成されるため、内容が的外れであったり、小さな文字にスペルミスが生じたりすることがあります。人物を忠実に再現するものではなく、画面下部の人物像などはラフにスケッチされます。ラベルが少なく、よりクリーンなイラストをご希望の場合は mid-century illustration poster を、写真から派生するようなインク画スタイルをお求めの場合は line art travel poster をお試しください。
コンセプトマップ・アートポスターの作り方
- 1
エフェクトを選ぶ
各ツールのページにあるサンプルを閲覧し、クレジットを使う前にどのような結果が得られるかを確認できます。
- 2
写真をアップロードする
JPEG、PNG、またはWebP形式で、最大12 MBまで。お客様の写真はプライバシーが保護され、いかなる学習にも使用されません。
- 3
キャプションを追加する
ほとんどのエフェクトでは、最終画像に表示されるテキストを任意の言語で設定できます。
- 4
結果をダウンロードする
高解像度の画像が手に入り、自由にご利用いただけます。2Kは100クレジット、4Kは200クレジットです。
このツールのプロンプト
これは、英語に翻訳された完全なプロンプトです。コピーして、参照写真を受け入れる任意の画像モデルで使用できます。
アップロードされた写真を、単一のハイエンドなデザインポスターに変換してください。複数の画像を組み合わせるのではなく、一つの作品として出力します。3:4の垂直レイアウトを使用し、フレームを上下50%ずつ、正確に二等分してください。

上半分には元の写真を保持します。被写体のアイデンティティ、構造、ポーズ、リアルな質感、自然光、そして元の色彩の雰囲気を維持してください。アート雑誌や独立系出版物、あるいは展示会の写真のように、軽く洗練されたグレーディングのみを施します。フレームに合わせるために周囲の背景を自然に拡張することは可能ですが、被写体を引き伸ばしたり、歪ませたり、変更したりしないでください。

下半分は、写真から最も認識しやすい被写体、輪郭、ポーズ、および物語的な関係性を抽出しますが、対象を直接的に描写はしません。代わりに、その情報を図解的な抽象表現、すなわち一種のコンセプトマッピングへと変換します。写真の核となるオブジェクトを「コンセプトの中心」として扱い、その動き、方向、空間、感情、関係性、メタファーを、単語、ノード、軌跡、ゾーン、矢印、結線へと分解してください。写真の背後にある思考プロセスや意味の構造を描き出すように構成します。

構成は、単語による「意味体系」、関係性による「幾何学体系」、そして「手書きの記号体系」の3つを組み合わせて構築してください。被写体の主要な輪郭や方向、ポーズをかすかな幾何学的骨組みとし、三角形、折れ線、交差する軸、放射状の線、関係線、角度のネットワーク、部分的なボックス選択によって合理的秩序を与えます。周囲には等高線のような曲線、磁力線、波形、あるいはパスを加え、絵が空間を通じて広がり、流れ、集まり、伸びていくようにします。標準的なフローチャートや科学的な図表にするのではなく、絵画と図解と思考ノートの中間に位置するアートとして仕上げてください。

画面には、繰り返される短い方向線、リズム感のあるマーク、点、チェック、記号、手書きのメモを多数配置し、その方向や密度が被写体の力、速度、感情、空間密度に従うような記号のフィールドを形成します。幾何学的な線は明快かつシャープで抑制されたものにし、手書きのマークは漂い、途切れ、わずかに変化させることで、理性的構造と身体的なストロークを対比させてください。関係性、方向、情報が呼吸できるよう、大きな余白を残してください。
よくある質問
元の写真は変わってしまいますか?
- 上半分はあなたの写真そのものであるべきです。同じ被写体、光、色を保ち、軽い色調補正を加え、必要に応じて背景の端を拡張します。ただし、画像生成モデルの特性上、稀に写真が描き直されてしまうことがあるため、使用前に上半分を確認してください。
下半分は写真をそのまま描いたものですか?
- 部分的にはそうです。プロンプトでは被写体の輪郭やポーズを「かすかな骨組み」として利用するよう指示しており、完全なコピーは求めていません。そのため、通常はシーンを忠実に再現するのではなく、メインの被写体をラフにスケッチし、その周囲を線や矢印、単語で囲んだものが生成されます。
書かれている言葉はどこから来るのですか?
- AIモデルが、写真に写っているものや、そこから推測されるテーマ(動き、情緒、関係性など)に基づいて生成します。通常は短い英単語と、創作されたタイトルが表示されます。独自のテキストを入力する欄はありません。元のプロンプトにテキスト指定の命令が含まれていないため、AIが生成したままの状態にしています。
言葉が間違っていることはありますか?
- はい、その可能性があります。ラベルは自動生成されるため、文脈に合わない言葉が出てくることもあります。また、無数の小さな単語が含まれるため、綴り間違いが混じることも珍しくありません(開発者のサンプル例にさえ含まれています)。印刷や共有の前には、必ずテキストの内容を確認してください。
テキストを中国語にすることはできますか?
- 確実ではありません。プロンプトで言語を指定しておらず、作成の元になったサンプルもほぼすべて英語です。稀に中国語の行が現れることもありますが、意図的に選択することはできません。
下半分がほとんど空白なのはなぜですか?
- これは意図的な演出です。要素間の関係性や方向性に「余白」を持たせるため、プロンプトで広いホワイトスペースを確保するよう指示しています。要素が密集しすぎるとフローチャートに近くなってしまいますが、このエフェクトではそれを避けるように設計されています。
生成されるサイズと所要時間を教えてください。
- 3:4の縦長画像が生成されます。100クレジットで2K(1792×2400)、200クレジットで4Kサイズを選択可能です。生成には通常60秒から90秒ほどかかります。
アップロードした写真はどのように扱われますか?
- アップロードされた写真はプライベートに保存され、画像の生成にのみ使用されます。一定期間で削除され、AIの学習に使用されることはありません。もし他の環境で試したい場合は、このページにプロンプトの全文を公開しています。