
Databricks Platformuna Giriş — Tüm Verileriniz, Analizleriniz ve Yapay Zekanız Tek Platformda
Hızlı Navigasyon
Etiketler
Slaytları paylaş
Databricks Platformuna Giriş — Tüm Verileriniz, Analizleriniz ve Yapay Zekanız Tek Platformda
Her slayt sayfasının detaylı görünümü, düzen, temel içerik ve görsel öğeler dahil.
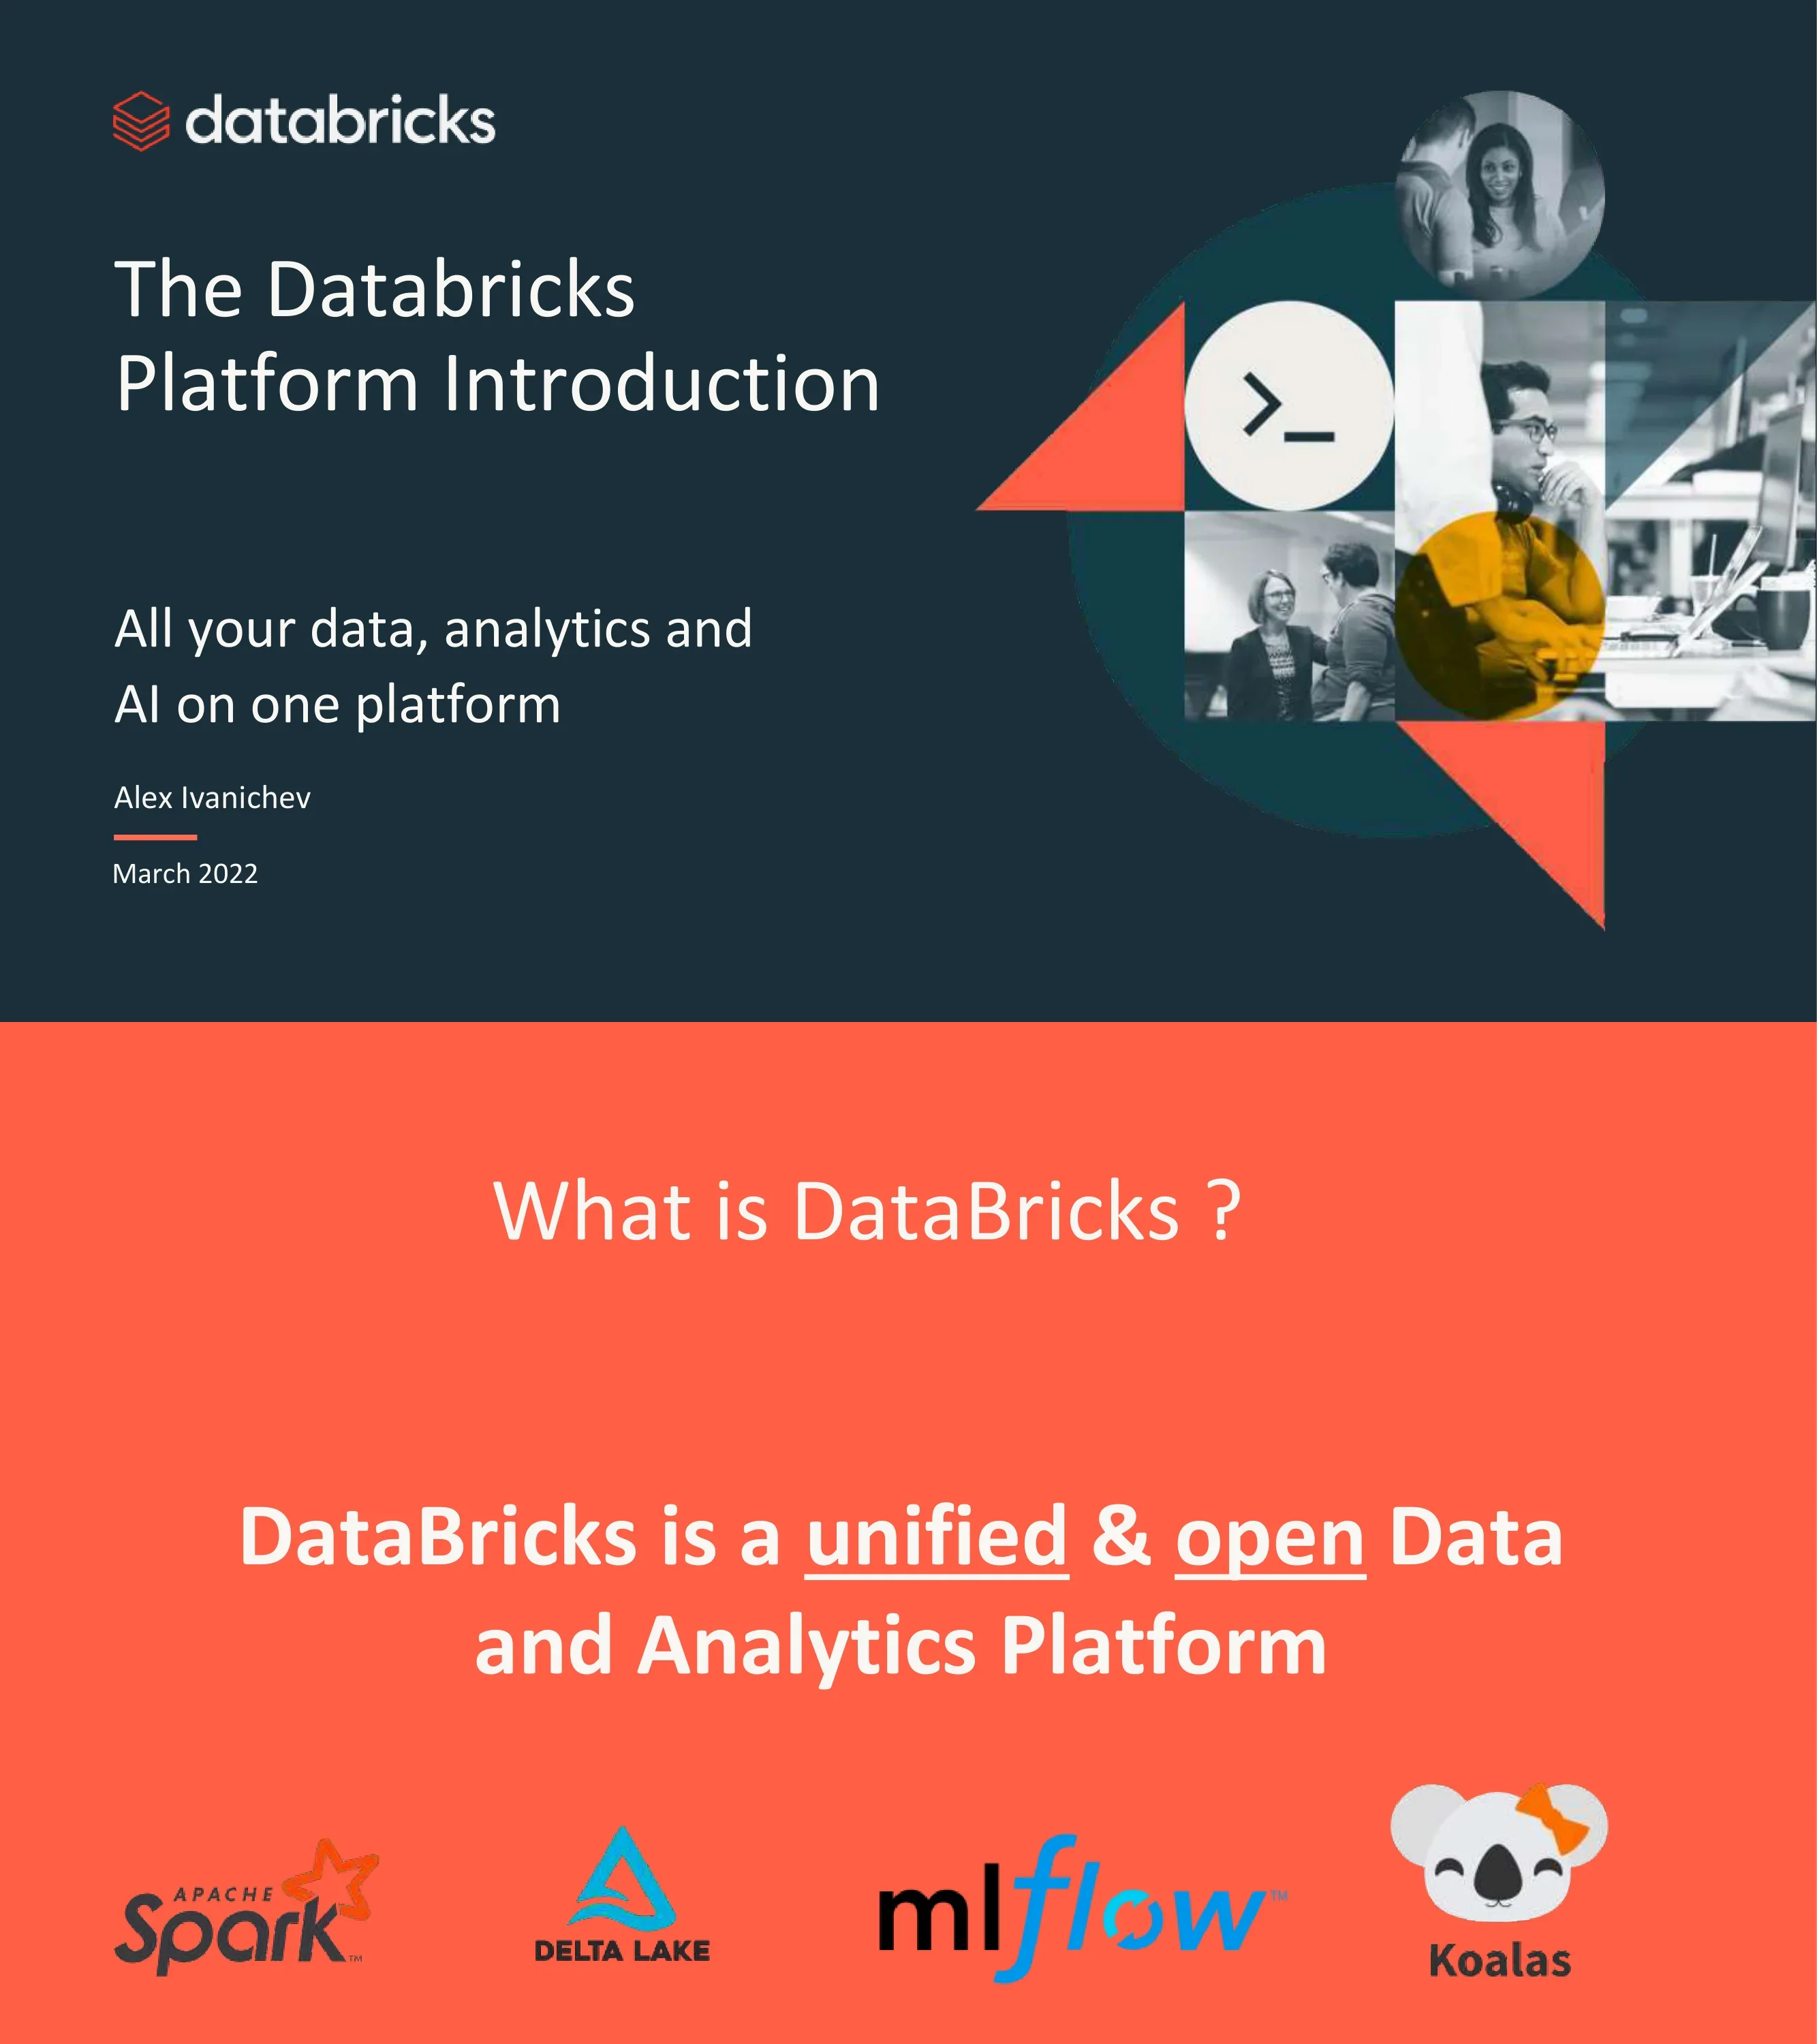
Başlık slaytı — Tüm verileriniz, analizleriniz ve yapay zekanız (AI) tek bir platformda. Yazan: Alex Ivanichev, Mart 2022
Sola hizalı başlık, yazar/tarih bilgisi, sağda geometrik fotoğraf kolajı
DataBricks, birleşik ve açık bir Veri ve Analitik Platformudur. Açık kaynak üzerinde inşa edilmiştir: Apache Spark, Delta Lake, MLflow ve Koalas
Mercan rengi arka plan üzerinde ortalanmış metin, altta dört OSS logosu
Sunumun temel bölümlerini gösteren görsel navigasyon yer tutucusu
Basit gündem layout'u
Veri yönetimi zorluklarının mevcut durumunu tanıtan bölüm ayırıcı
Yeşil arka plan üzerinde ortalanmış beyaz metin
Üç silolanmış yığın — Veri Ambarı (Data Warehousing), Veri Mühendisliği (Data Engineering), Veri Bilimi/ML — bağlantısız sistemler ve tescilli formatlarla. Veri ambarı, veri gölü, akış ve ML işlem hatları arasındaki ETL akışlarını gösterir
Üç sütunlu başlık, altında mimari akış şeması
Modern veri ekiplerindeki üç temel rolü gösteren üçgen diyagramı: Veri Analistleri, Veri Mühendisleri ve Veri Bilimcileri
Her köşede rol ikonları bulunan ortalanmış üçgen
Veri Ambarı'nın (yapılandırılmış, veritabanı ikonu) Veri Gölü ile (yapılandırılmamış, dalgalar ikonu) görsel karşılaştırması
Yan yana iki büyük ikon ve etiketler
Karmaşıklığın üç boyutu: verilerin iki ayrı kopyası (Tescilli - Proprietary - ve Açık), uyumsuz arayüzler (SQL ve Python), uyumsuz güvenlik/yönetişim modelleri (Tablolar ve Dosyalar)
Ambar ve göl sütunlarıyla üç karşılaştırma satırı
Tüm verileri, analizleri ve AI iş yüklerini birleştirmek için tek bir platform. Veri Ambarı ve Veri Gölü'nü, Akış Analizi, BI, Veri Bilimi ve Makine Öğrenimi'ni destekleyen tek bir katmanda birleştirir
Hem ambar hem de gölden birleşik katmana veri akışıyla ortalanmış mimari şeması
Modern Veri Yığını'nın (Fivetran → Airflow → dbt → Snowflake → Looker/Tableau) Databricks Ekosistemi ile (Fivetran + 100 araç → Nesne Depolama → Otomatik Alma → Delta + Spark → Delta Live Tables → Databricks SQL) yan yana karşılaştırması
İki sütunlu dikey akış karşılaştırması
Lakehouse mimari yığını: Altta Bulut Veri Gölü (Azure, AWS, GCP), açık format depolama, veri işleme, güvenlik/yönetişim ve üstte rol tabanlı deneyimler. Faydaları: lake-first, AI/ML native, yüksek güvenilirlik, çoklu bulut
Solda yığılmış mimari diyagramı, sağda madde işaretleri
Veri Lakehouse Temeli bölümü için bölüm ayırıcı
Geometrik vurgu şekilleriyle koyu teal arka plan üzerinde beyaz metin
Delta Lake, Veri Gölü ve Veri Ambarı arasında köprü kurar — veri yönetimi ve yönetişimine açık bir yaklaşım. Temel faydaları: işlemlerle daha iyi güvenilirlik, indeksleme ile 48 kat daha hızlı işleme, hassas erişim kontrolü
Üç sütunlu düzen: Veri Gölü simgesi | Delta Lake logosu + faydaları | Veri Ambarı simgesi
Veri göllerindeki Lakehouse mimarisi için açık kaynak projesi. Spark için ACID işlemleriyle depolama katmanı. Temel özellikler: ACID İşlemleri, Ölçeklenebilir Meta Veri, Zaman Yolculuğu, Açık Format, Değişim Veri Akışı, Birleşik Toplu/Akış, Şema Uygulama/Evrimi, Denetim Geçmişi
İki sütunda madde işaretleriyle başlık
Çözülen üç zorluk: Güvenilirlik & Kalite → ACID işlemleri, Performans & Gecikme → Gelişmiş indeksleme & önbelleğe alma, Yönetişim → Veri Katalogları ile Yönetişim
Zorluktan çözüme oklarla üç satır
Transaction log yapısı: Dosya Ekle, Dosya Kaldır, Meta Veriyi Güncelle, Transaction Ayarla, Protokolü Değiştir, Commit Bilgisi. JSON commit'leri ve parquet dosya ekleme/kaldırma işlemlerini içeren _delta_log dizinini gösterir
Üstte madde işaretli liste, altta iki kod/diyagram paneli
Delta Lake, Parquet formatında her 10 commit'te bir checkpoint dosyaları oluşturur. Checkpoint dosya yapısını, listFrom versiyon mekanizmasını ve iyimser eşzamanlılık ile eşzamanlı okuma/yazma işlemeyi gösterir
Dosya yapısını ve okuma/yazma akışını gösteren iki diyagram paneli
Bronz-Gümüş-Altın madalyon mimarisi: Bronz (ham alım/geçmiş) → Gümüş (filtrelenmiş, temizlenmiş, zenginleştirilmiş) → Altın (iş seviyesi toplamları). Kaynaklar: Kafka, Kinesis, CSV/JSON, Spark. Tüketiciler: Streaming Analytics, BI, Data Science/ML
Üç veritabanı katmanıyla soldan sağa veri akışı
Birden çok kaynak, işleme aşaması ve tüketici arasındaki karmaşık bağımlılıkları gösteren karmaşık gerçek dünya veri hattı diyagramı. Ölçekte kalite ve güvenilirliği korumak karmaşık ve kırılgandır
Birçok kesikli çizginin kesiştiği karmaşık boru hattı diyagramı
Databricks Lakehouse Platformunda Veri Mühendisliği: Veri alımı → Veri dönüşümü → Veri kalitesi yönetimi → Otomatik dağıtım ve operasyonlar → Gözlemlenebilirlik, soy ve boru hattı görünürlüğü. Zamanlama ve orkestrasyon. Temelde Delta Lake açık format depolama
Solda veri kaynakları ve sağda tüketiciler bulunan katmanlı platform diyagramı
Çalışma alanı özellikleri bölümü için bölüm ayırıcı
Mercan rengi arka planda ortalanmış metin
Kümeler, Veri Analitiği, Veri Bilimi veya Veri Mühendisliği iş yükleri için işlem kaynakları sağlar. Databricks Runtime 7.5 ML, Spark 3.0.1, Community Optimized sürücü türü ile küme yapılandırma arayüzünü gösterir
Üstte açıklama metni, altta tam genişlikte UI ekran görüntüsü
Dosyalar, tablolar, görselleştirmeler ve anlatı metni için çalıştırılabilir hücrelere sahip kod yazmak ve yürütmek için web arayüzü. Örnekleme stratejileri içeriği ve revizyon geçmişi olan not defterini gösterir
Üstte açıklama metni, altta not defteri ekran görüntüsü
Auto Loader, bulut depolamadan (GCS, DBFS) yeni veri dosyalarını artımlı olarak işler. Önce/Sonra karşılaştırması: karmaşık Notification Service + Message Queue + Airflow kurulumunu ortadan kaldırır. Scala kod örneği içerir
Açıklama, önce/sonra diyagramları ve kod parçacığı
Jobs, ETL, Model Oluşturma vb. için planlanmış olarak not defterlerini çalıştırır. Bir DAG iş akışını gösterir: Clicks_Ingest → Sessionize + Orders_Ingest → Match → Build_Features → Persist_Features + Train
Üstte açıklama metni, altta DAG iş akışı diyagramı
Veri ardışık düzenlerini bildirimsel olarak tanımlamak, dağıtmak, test etmek ve yükseltmek için framework. Tablo bağımlılıklarının ve olay günlüğünün grafik görünümü ile DLT ardışık düzeni UI'ını gösterir
Üstte açıklama metni, tam genişlikte DLT ardışık düzeni ekran görüntüsü
GitHub, GitLab, Bitbucket ve Azure DevOps ile havuz düzeyinde entegrasyon. Geliştiriciler doğrudan çalışma alanından dalları klonlayabilir, yönetebilir, değişiklikleri gönderebilir/çekebilir
Üstte açıklama metni, dosya tarayıcısı olan Repos UI ekran görüntüsü
ML modellerinin tüm yaşam döngüsünü yönetmek için MLflow Model Registry. Model sürümlemeyi, aşama geçişlerini (Arşivlenmiş, Üretim, Hazırlık) ve bekleyen istekleri gösterir
Üstte açıklama metni, sürüm tablosu olan Model Registry ekran görüntüsü
Yönetişim bölümü için bölüm ayırıcı
Mercan rengi arka planda ortalanmış metin
Karmaşıklığı gösteren diyagram: 4 veri türü (Yapılandırılmış, Yarı yapılandırılmış, Yapılandırılmamış, Akış) × 3 bulut × ayrı güvenlik politikaları × birden çok çıktı kopyası
Veri türlerinden bulutlara, güvenlikten çıktılara akış diyagramı
Kuruluşların çeşitli veri ürünlerini paylaşması ve yönetmesi gerekir: Dosyalar, Panolar, Modeller ve Tablolar
Etiketli dört simge yan yana
Veri/AI varlıklarını merkezi olarak kataloglayın, arayın ve keşfedin. Birleşik çapraz bulut yönetim modeli. Mevcut Kurumsal Veri Katalogları ile entegrasyon. Delta Sharing ile güvenli canlı veri paylaşımı
Solda Unity Catalog ekran görüntüsü, sağda dört madde işareti
Güvenli veri paylaşımı için açık protokol: Veri Sağlayıcı → Delta Lake Tablosu → Delta Sharing Sunucusu → Delta Sharing Protokolü → Veri Alıcısı (Power BI, Tableau, Spark, pandas, Java)
Sağlayıcıdan alıcıya soldan sağa akış şeması
ML çalışma alanı bölümü için bölüm ayırıcı
Yeşil arka planda ortalanmış metin
Yan yana karşılaştırma: Veri Ambarı (BI Uygulamaları → SQL Motoru → Tescilli Depolama) - Veri Lakehouse (ML Uygulamaları + BI Uygulamaları → Python/R + SQL Motoru → OSS formatlarıyla Bulut Depolama: PNG, UTF-8, Parquet)
Yan yana iki mimari şeması
Tam ML yaşam döngüsü için veri-tabanlı işbirlikçi çözüm: İşbirlikçi Çok Dilde Not Defterleri → Model Eğitimi/Ayarlama, Model İzleme/Kayıt, Model Sunumu/İzleme, Otomasyon/Yönetişim → Açık Çoklu Bulut Veri Gölü Evi ve Özellik Deposu
Üç katmanlı yığılmış platform diyagramı
Dört gereksinim: Yapılandırılmamış Veriye Erişim (görüntüler, metin, petabaytlara ölçekleme), Açık Kaynak Kütüphaneleri (TensorFlow, scikit-learn, R), Özel Donanım (GPU'lar, bulut esnekliği), Model Yaşam Döngüsü Yönetimi (artefaktlar, soy, üretime alma)
Madde işaretli dört çeyrekli düzen
İş Zekası (SQL, BI araçları, Büyük Veri, Veri Ambarı), Veri Bilimi (R, SAS, Python, istatistiksel analiz, küçük veri kümeleri), Makine Öğrenimi (Python, derin öğrenme, GPU'lar, büyük veri kümeleri, yapılandırılmamış veri). ML bölümü deniz mavisi kenarlıkla vurgulanmıştır
Rol simgeleriyle üç sütunlu karşılaştırma
ML, yapılandırılmamış veriler üzerinde çalışır, büyük veri kümeleri gerektirir, açık kaynak DataFrames kullanır (SQL değil), modeller üretir (raporlar değil) ve bazen özel donanıma (GPU'lar) ihtiyaç duyar
Solda madde işareti listesi, sağda büyük dişli/kişi simgesi
Lakehouse üzerinde hem model eğitmek hem de çalıştırmak için açık araçlar. Modeller de veridir. MLOps için MLflow: model verilerini, soyunu, girdilerini izle/yönet; modelleri lakehouse hizmetleri olarak dağıt
Solda madde işareti listesi, sağda teslimat kamyonu simgesi
Tablolar yapılandırılmış model girdisini yönetir ancak şunları içermez: upstream lineage, downstream lineage, model çağıran entegrasyonu ve gerçek zamanlı erişim. Feature store'lar bu boşlukları doldurur
Solda madde işaretli liste, sağda veritabanı ikonu
Bölüm ayırıcı — Yerleşik sorgu düzenleyici, uyarılar, görselleştirmeler ve etkileşimli panolar ile ANSI SQL kullanarak data lake verilerini sorgulayın
Yeşil arka plan üzerinde açıklama ile ortalanmış metin
Otomatik tamamlama, tablo tarayıcı ve uç nokta bağlantısı olan SQL sorgu düzenleyici. Sütun önerileriyle NYC taksi veri kümesi sorgusunu gösterir
Üstte açıklama metni, altta sorgu düzenleyici ekran görüntüsü
Görselleştirmeleri birleştiren SQL panoları: Üretilen Nakit ($16M), Satış Sayısı (103K), Aylık Büyüme (%13), Ortalama Sepet ($154), Müşteri Özeti haritası, Güne Göre Miktar grafiği, Ürün Kategorisi pasta grafiği
Çoklu widget türleri içeren tam genişlikte pano ekran görüntüsü
Planlanmış sorgu sonuçları eşikleri karşıladığında uyarılar bildirim gönderir. Uyarı oluşturma UI'sini, tetiklenmiş/Tamam durumlarına sahip uyarı listesini ve hedefleri (Pops, Platform, Test Webhook) olan Genel Uyarı yapılandırmasını gösterir
Üstte açıklama metni, ızgarada dört UI ekran görüntüsü
SQL uç noktaları aracılığıyla gerçekleştirilen SQL sorgularını yürütme ayrıntılarıyla gösteren sorgu geçmişi: süre dökümü (optimizasyon %35, yürütme %64, getirme %1), döndürülen satırlar, okunan bayt
Üstte açıklama, kenar çubuğu + sorgu listesi + ayrıntı paneli ekran görüntüsü
Databricks markasıyla kapanış slaytı
Geometrik şekillerle koyu teal arka plan üzerinde basit teşekkür metni
Bu slayt ve temel sunum içeriği hakkında yaygın sorular.
Databricks, veri ambarlarının ve veri göllerinin en iyilerini tek bir Lakehouse mimarisinde birleştiren birleşik ve açık bir veri platformudur. Apache Spark, Delta Lake ve MLflow gibi açık kaynaklı teknolojiler üzerine inşa edilmiş tek bir platformda veri mühendisliğini, veri bilimini, machine learning'i ve SQL analitiğini destekler.
Bu 46 slaytlık deste şunları kapsar: mevcut veri yönetimi zorlukları, Data Lakehouse kavramı, Delta Lake temeli (ACID işlemleri, kontrol noktaları, madalyon mimarisi), Databricks çalışma alanı özellikleri (kümeler, not defterleri, işler, depolar, modeller, Delta Live Tables, AutoLoader), Unity Catalog ve Delta Sharing ile veri yönetişimi, ML çalışma alanı ve MLOps ve SQL Analytics çalışma alanı (sorgular, panolar, uyarılar).
Bu sunum, Databricks platformunu anlamak isteyen veri mühendisleri, veri bilimcileri, veri analistleri ve teknik karar vericiler için tasarlanmıştır. Hem bir satış etkinleştirme aracı hem de Databricks'i değerlendiren veya benimseyen ekipler için eğitici bir alıştırma kaynağı olarak hizmet eder.
Sunum, modern veri yığınının birden çok ayrı araç (Fivetran, Airflow, dbt, Snowflake, Looker, Tableau) gerektirdiğini, Databricks ekosisteminin ise bunları Auto Ingest, Delta + Spark, Delta Live Tables ve Databricks SQL ile birleşik bir platformda birleştirdiğini gösteren doğrudan bir karşılaştırma içerir.
Delta Lake, veri göllerine ACID işlemleri, ölçeklenebilir meta veri işleme ve birleşik toplu/akış işleme getiren açık kaynaklı bir depolama katmanıdır. Veri sürümü oluşturma için zaman yolculuğu, şema zorlama ve ayrıntılı erişim kontrolü ile 48 kat daha hızlı veri işleme sağlar - veri göllerini veri ambarları kadar güvenilir hale getirir.
Evet, sunum kümeler, not defterleri, AutoLoader, işler, Delta Live Tables, depolar, MLflow Model Registry, SQL sorguları, panolar, uyarılar, sorgu geçmişi ve Unity Catalog için özgün Databricks kullanıcı arayüzü ekran görüntüleri içerir - platform deneyiminin gerçekçi bir görünümünü sağlar.
Evet, PPTX dosyası tamamen düzenlenebilir. Verileri güncelleyebilir, şirket bağlamınızı ekleyebilir, mimari şemalarını değiştirebilir ve içeriği ister satış demoları, ister dahili eğitim veya teknik sunumlar olsun, belirli hedef kitleniz için özelleştirebilirsiniz.
Databricks çoklu buluttur ve Microsoft Azure, AWS ve Google Cloud ile çalışır. Sunum, verileriniz açık formatlar kullanılarak kendi bulut veri gölünüzde depolanırken bu çoklu bulut yeteneğini önemli bir avantaj olarak vurgular.

Create Your Own Slides
Turn your ideas into professional presentations in seconds with 2slides AI.
Profesyonel tasarımları referans alın, stilinizi seçin ve mükemmel metin oluşturma ile slaytlar oluşturun. Nano Banana ile desteklenir—şimdi sunumunuzu oluşturmaya başlayın.
Your AI Agent for slides. Save time, shine faster with intelligent presentation creation.


© 2026 2slides. All rights reserved.