
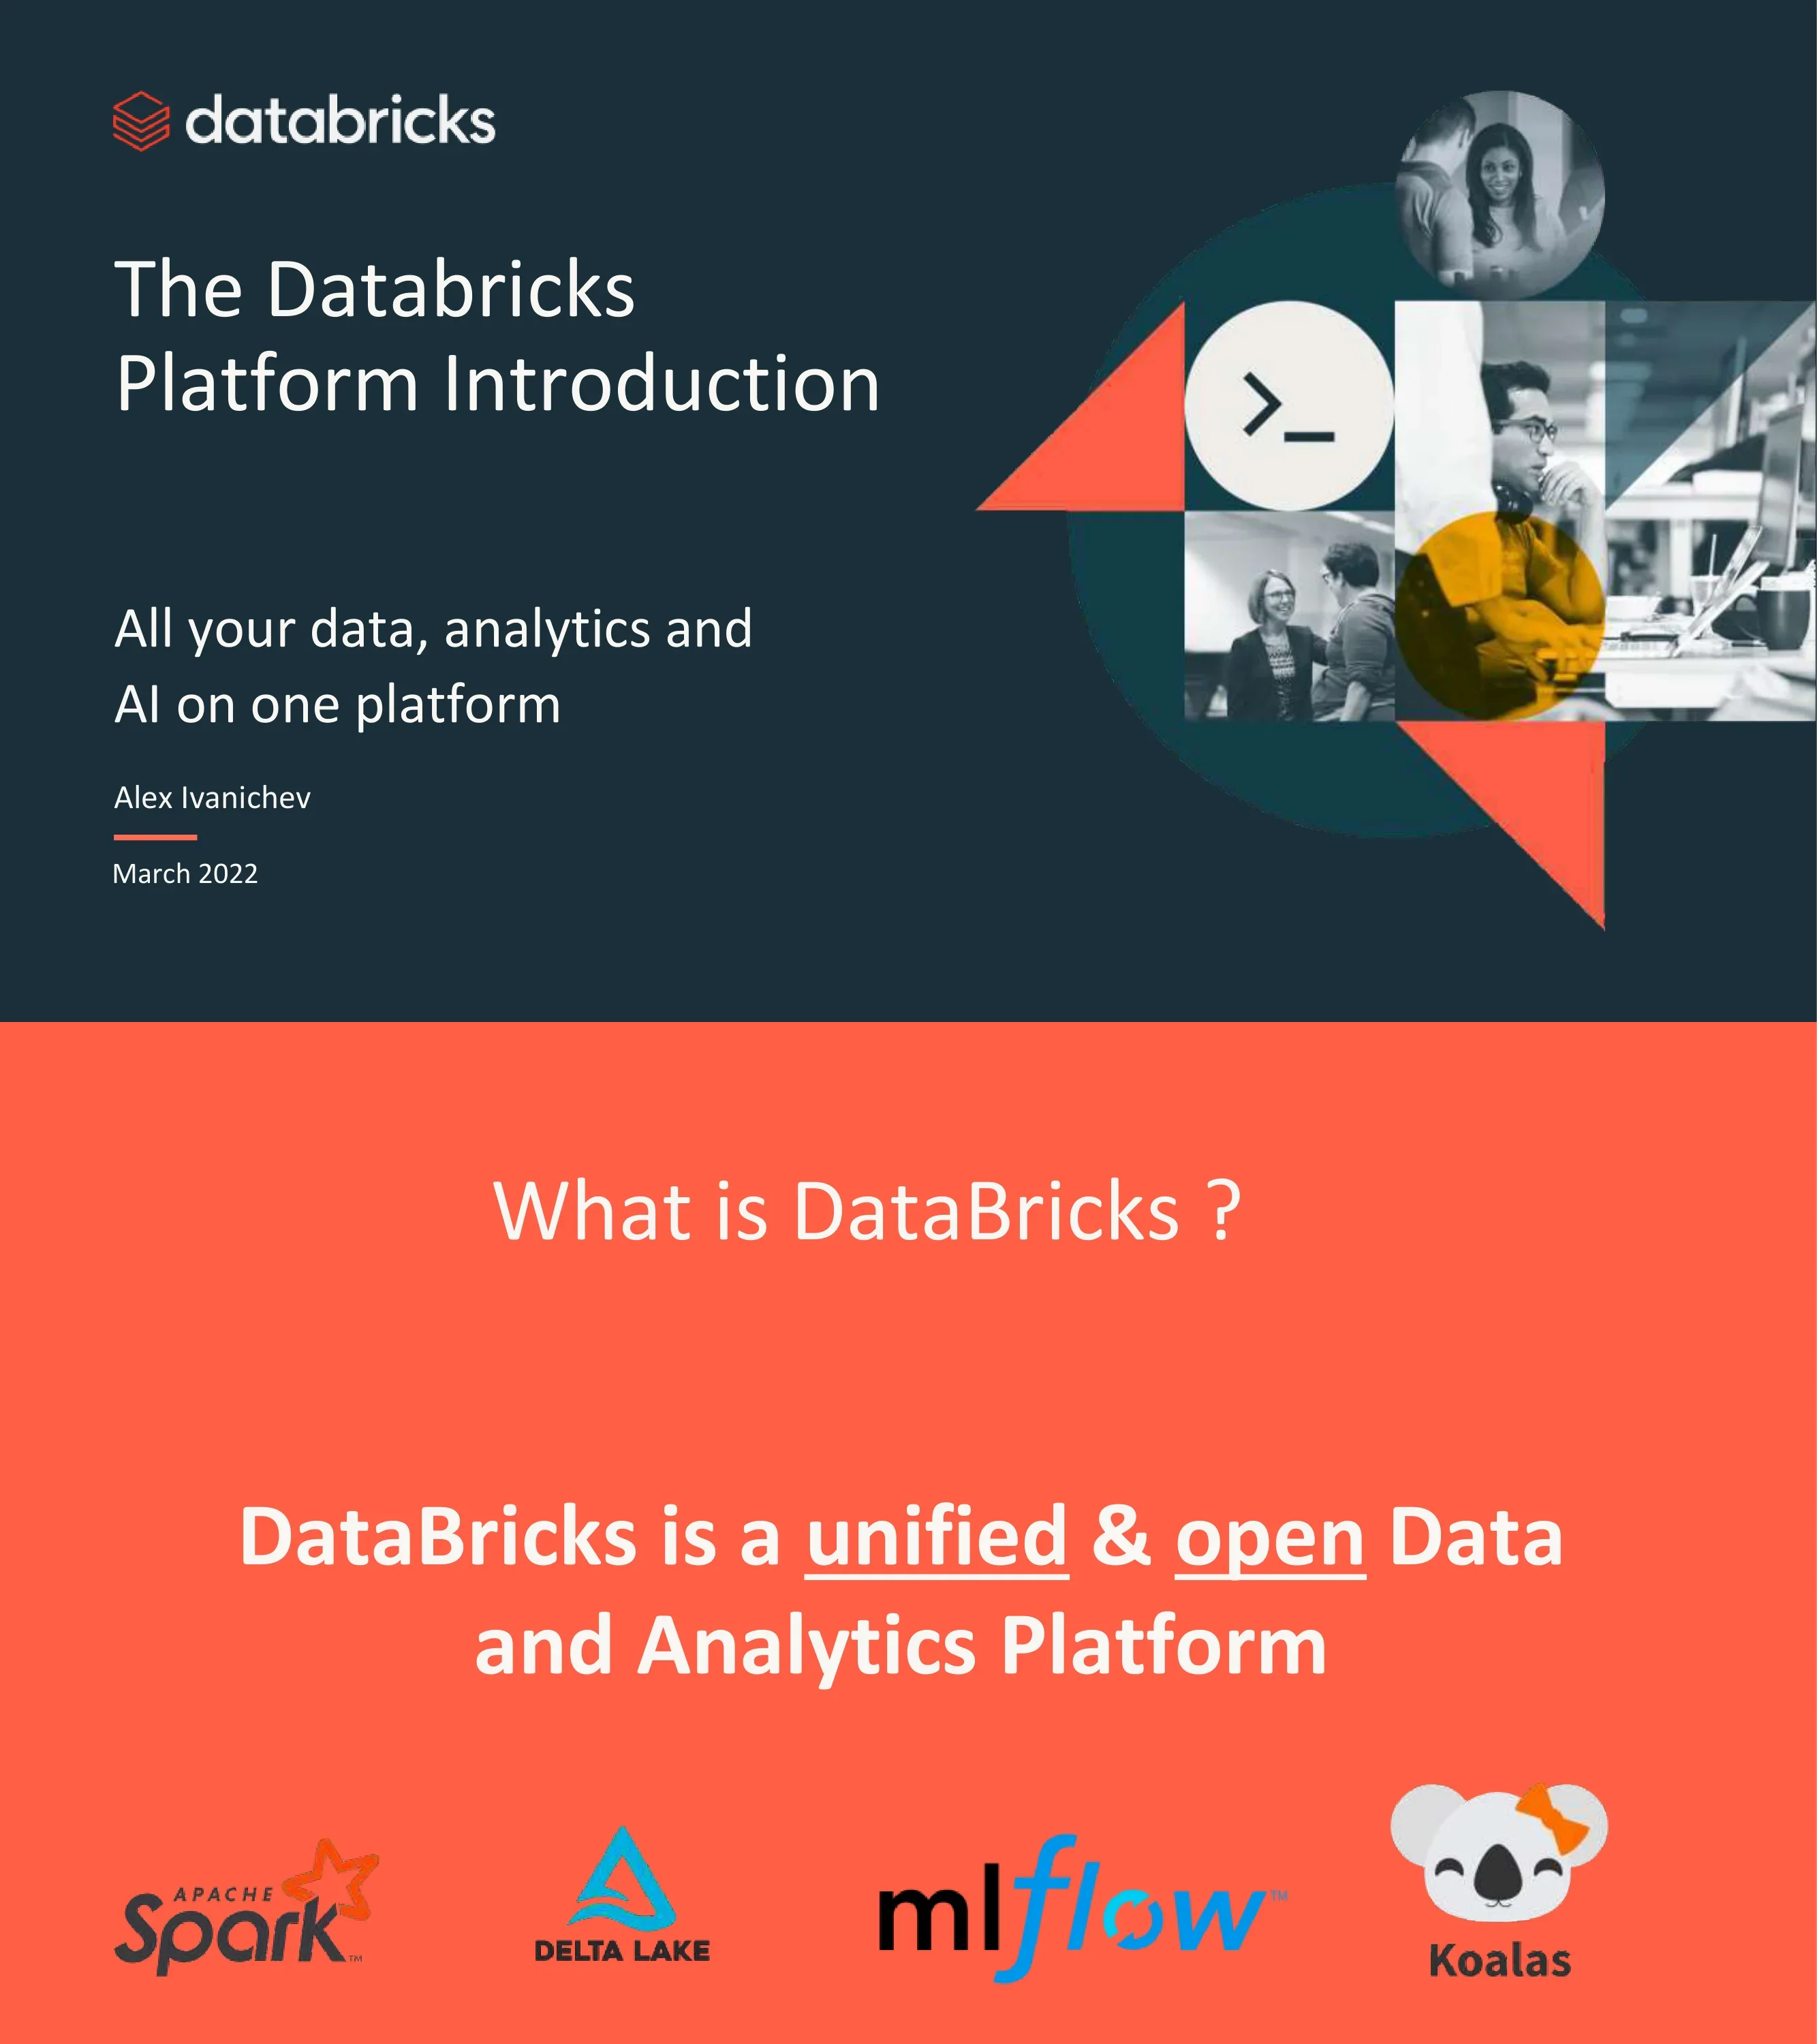
Databricks Platform Introduction — все ваши данные, аналитика и AI на одной платформе
Быстрая навигация
Теги
Поделиться слайдами
Databricks Platform Introduction — все ваши данные, аналитика и AI на одной платформе
Подробный просмотр каждой страницы слайда, включая макет, ключевой контент и визуальные элементы.
Титульный слайд — Все ваши данные, аналитика и AI на одной платформе. Автор: Алекс Иваничев, март 2022
Заголовок с выравниванием по левому краю, автор/дата, геометрический фотоколлаж справа
DataBricks — это унифицированная и открытая платформа для данных и аналитики. Построена на основе open-source: Apache Spark, Delta Lake, MLflow и Koalas
Текст по центру на коралловом фоне с четырьмя логотипами OSS внизу
Визуальный навигационный элемент, показывающий ключевые разделы презентации
Простая структура agenda
Разделитель разделов, представляющий текущее состояние проблем управления данными
Белый текст по центру на зеленом фоне
Три изолированных стека — Data Warehousing, Data Engineering, Data Science/ML — с разъединенными системами и проприетарными форматами. Показаны потоки ETL между хранилищем данных, озером данных, потоковой передачей и конвейерами ML
Трехколоночный заголовок со схемой потока архитектуры ниже
Треугольная диаграмма, показывающая три ключевые роли в современных командах по работе с данными: Data Analysts, Data Engineers и Data Scientists
Центрированный треугольник со значками ролей на каждой вершине
Визуальное сравнение Data Warehouse (структурированные данные, значок базы данных) и Data Lake (неструктурированные данные, значок волн)
Два больших значка рядом с метками
Три измерения сложности: две отдельные копии данных (Proprietary vs Open), несовместимые интерфейсы (SQL vs Python), несовместимые модели безопасности/управления (Tables vs Files)
Три строки сравнения со столбцами warehouse vs lake
Одна платформа для объединения всех данных, аналитики и AI-нагрузок. Объединяет Data Warehouse и Data Lake в единый слой, поддерживающий Streaming Analytics, BI, Data Science и Machine Learning
Центрированная схема архитектуры с потоком данных как из warehouse, так и из lake в унифицированный слой
Сравнение Modern Data Stack (Fivetran → Airflow → dbt → Snowflake → Looker/Tableau) и экосистемы Databricks (Fivetran + 100 tools → Object Storage → Auto Ingest → Delta + Spark → Delta Live Tables → Databricks SQL)
Двухколоночное вертикальное сравнение потоков
Архитектура Lakehouse: Cloud Data Lake внизу (Azure, AWS, GCP), хранилище в открытом формате, обработка данных, безопасность/управление и ролевые возможности сверху. Преимущества: lake-first, нативная поддержка AI/ML, высокая надежность, мультиоблачность
Диаграмма многоуровневой архитектуры слева, маркированный список справа
Разделитель секции для главы Data Lakehouse Foundation
Белый текст на темно-бирюзовом фоне с геометрическими акцентными фигурами
Delta Lake соединяет Data Lake и Data Warehouse — открытый подход к управлению данными и управлению. Ключевые преимущества: лучшая надежность благодаря транзакциям, в 48 раз более быстрая обработка с индексацией, детальный контроль доступа
Трехколоночный макет: иконка Data Lake | логотип Delta Lake + преимущества | иконка Data Warehouse
Проект с открытым исходным кодом для архитектуры Lakehouse на озерах данных. Уровень хранения с ACID-транзакциями для Spark. Ключевые особенности: ACID Transactions, Scalable Metadata, Time Travel, Open Format, Change Data Feed, Unified Batch/Streaming, Schema Enforcement/Evolution, Audit History
Заголовок с маркированным списком в два столбца
Три решенные задачи: Надежность и качество → ACID-транзакции, Производительность и задержка → Расширенная индексация и кэширование, Управление → Управление с помощью Data Catalogs
Три строки со стрелками от проблемы к решению
Структура журнала транзакций: Add File, Remove File, Update Metadata, Set Transaction, Change Protocol, Commit Info. Показан каталог _delta_log с JSON-коммитами и операциями добавления/удаления файлов parquet
Список маркеров вверху, две панели кода/диаграммы ниже
Delta Lake генерирует файлы контрольных точек каждые 10 коммитов в формате Parquet. Показана структура файла контрольной точки, механизм listFrom version и обработка параллельных операций чтения/записи с оптимистичным параллелизмом
Две панели диаграмм, показывающие структуру файлов и поток чтения/записи
Медальонная архитектура Bronze-Silver-Gold: Bronze (необработанное получение/история) → Silver (фильтрованное, очищенное, дополненное) → Gold (агрегаты бизнес-уровня). Источники: Kafka, Kinesis, CSV/JSON, Spark. Потребители: Streaming Analytics, BI, Data Science/ML
Поток данных слева направо с тремя уровнями баз данных
Сложная диаграмма реального конвейера данных, показывающая запутанные зависимости между несколькими источниками, этапами обработки и потребителями. Поддержание качества и надежности в масштабе является сложным и хрупким
Беспорядочная диаграмма конвейера со множеством пересекающихся пунктирных линий
Инженерия данных на платформе Databricks Lakehouse: Загрузка данных → Преобразование данных → Управление качеством данных → Автоматическое развертывание и операции → Наблюдаемость, происхождение и видимость конвейера. Планирование и оркестрация. Открытый формат хранения Delta Lake в основе
Многоуровневая диаграмма платформы с источниками данных слева и потребителями справа
Разделитель секции для главы о функциях рабочей среды
Текст, выровненный по центру, на коралловом фоне
Кластеры предоставляют вычислительные ресурсы для Data Analytics, Data Science или Data Engineering задач. Показан UI конфигурации кластера с Databricks Runtime 7.5 ML, Spark 3.0.1, Community Optimized driver type
Текст описания вверху, скриншот UI во всю ширину ниже
Веб-интерфейс для написания и выполнения кода с запускаемыми ячейками для файлов, таблиц, визуализаций и пояснительного текста. Показан notebook с контентом о стратегиях выборки и историей изменений
Текст описания вверху, скриншот notebook ниже
Auto Loader инкрементно обрабатывает новые файлы данных из облачного хранилища (GCS, DBFS). Сравнение «До/После»: устраняет сложную настройку Notification Service + Message Queue + Airflow. Включает пример кода Scala
Описание, диаграммы «до/после» и фрагмент кода
Jobs запускают notebooks по расписанию для ETL, Model Building и т. д. Показан рабочий процесс DAG: Clicks_Ingest → Sessionize + Orders_Ingest → Match → Build_Features → Persist_Features + Train
Текст описания вверху, диаграмма рабочего процесса DAG ниже
Фреймворк для декларативного определения, развертывания, тестирования и обновления конвейеров данных. Показан UI конвейера DLT с графическим представлением зависимостей таблиц и журналом событий
Текст описания вверху, скриншот конвейера DLT во всю ширину
Интеграция на уровне репозитория с GitHub, GitLab, Bitbucket и Azure DevOps. Разработчики могут клонировать, управлять ветвями, отправлять/получать изменения непосредственно из рабочей среды
Текст описания вверху, скриншот UI Repos с файловым браузером
MLflow Model Registry для управления всем жизненным циклом ML моделей. Показаны версионирование моделей, переходы между стадиями (Archived, Production, Staging) и ожидающие запросы
Текст описания вверху, скриншот Model Registry с таблицей версий
Разделитель секции для главы об управлении данными
Текст, выровненный по центру, на коралловом фоне
Диаграмма, показывающая сложность: 4 типа данных (Structured, Semi-structured, Unstructured, Streaming) × 3 облака × отдельные политики безопасности × несколько выходных копий
Блок-схема от типов данных через облака через безопасность к выходам
Предприятиям необходимо совместно использовать и управлять разнообразными продуктами данных: файлами, панелями мониторинга, моделями и таблицами
Четыре значка в ряд с подписями
Централизованный каталог, поиск и обнаружение данных/AI активов. Унифицированная модель управления для разных облаков. Интеграция с существующими корпоративными каталогами данных. Безопасный обмен данными в реальном времени с Delta Sharing
Скриншот Unity Catalog слева, четыре пункта справа
Открытый протокол для безопасного обмена данными: Data Provider → Delta Lake Table → Delta Sharing Server → Delta Sharing Protocol → Data Recipient (Power BI, Tableau, Spark, pandas, Java)
Блок-схема слева направо от поставщика к получателю
Разделитель разделов для главы рабочей области ML
Текст по центру на зеленом фоне
Параллельное сравнение: Data Warehouse (BI Apps → SQL Engine → Proprietary Storage) vs Data Lakehouse (ML Apps + BI Apps → Python/R + SQL Engine → Cloud Storage with OSS formats: PNG, UTF-8, Parquet)
Две архитектурные диаграммы рядом
Ориентированное на данные решение для совместной работы на протяжении всего жизненного цикла ML: Совместные многоязыковые блокноты → Обучение/Тюнинг моделей, Отслеживание/Реестр моделей, Обслуживание/Мониторинг моделей, Автоматизация/Управление → Открытое мультиоблачное озеро данных и хранилище признаков (Data Lakehouse and Feature Store)
Трехуровневая диаграмма платформы
Четыре требования: Доступ к неструктурированным данным (изображения, текст, масштабирование до петабайт), библиотеки Open Source (TensorFlow, scikit-learn, R), специализированное оборудование (GPU, облачная эластичность), управление жизненным циклом моделей (артефакты, происхождение, внедрение в производство)
Четырехквадрантная структура с маркированными пунктами
Business Intelligence (SQL, BI tools, Big Data, Warehouse), Data Science (R, SAS, Python, статистический анализ, небольшие наборы данных), Machine Learning (Python, глубокое обучение, GPU, большие наборы данных, неструктурированные данные). Секция ML выделена бирюзовой рамкой
Сравнение в трех колонках с иконками ролей
ML работает с неструктурированными данными, требует огромные наборы данных, использует DataFrames с открытым исходным кодом (не SQL), выдает модели (не отчеты) и иногда нуждается в специальном оборудовании (GPU)
Маркированный список слева, большая иконка шестеренки/человека справа
Открытые инструменты для *обучения* и *эксплуатации* моделей в lakehouse. Модели - это тоже данные. MLflow для MLOps: отслеживание/управление данными моделей, происхождением, входными данными; развертывание моделей как сервисов lakehouse
Маркированный список слева, иконка грузовика доставки справа
Таблицы управляют структурированным вводом модели, но им не хватает: upstream lineage, downstream lineage, интеграции вызывающей модели и доступа в реальном времени. Feature stores решают эти проблемы
Список с маркерами слева, иконка базы данных справа
Разделитель секции — Запрашивайте данные data lake, используя ANSI SQL со встроенным редактором запросов, оповещениями, визуализациями и интерактивными дашбордами
Центрированный текст на зеленом фоне с описанием
SQL-редактор запросов с автозаполнением, браузером таблиц и подключением к endpoint. Показывает запрос набора данных NYC taxi с предложениями столбцов
Текст описания вверху, скриншот редактора запросов ниже
SQL-дашборды, объединяющие визуализации: Cash Generated ($16M), Number of Sales (103K), Monthly Growth (13%), Average Basket ($154), карта Customer Summary, график Amount per Day, круговая диаграмма Product Category
Полноэкранный скриншот дашборда с несколькими типами виджетов
Оповещения уведомляют, когда результаты запланированного запроса достигают пороговых значений. Показывает UI создания оповещений, список оповещений со статусами triggered/OK и конфигурацию Generic Alert с назначениями (Pops, Platform, Test Webhook)
Текст описания вверху, четыре скриншота UI в сетке
История запросов, показывающая SQL-запросы, выполненные через SQL endpoints, с деталями выполнения: разбивкой по продолжительности (оптимизация 35%, выполнение 64%, получение 1%), количеством возвращенных строк, количеством прочитанных байтов
Описание вверху, боковая панель + список запросов + скриншот панели деталей
Заключительный слайд с брендингом Databricks
Простой текст благодарности на темно-бирюзовом фоне с геометрическими фигурами
Распространенные вопросы об этом слайде и основном содержании презентации.
Databricks — это унифицированная и открытая платформа данных, которая объединяет лучшее из data warehouse и data lake в единую архитектуру Lakehouse. Она поддерживает инженерию данных, data science, машинное обучение и SQL-аналитику на одной платформе, построенной на технологиях с открытым исходным кодом, таких как Apache Spark, Delta Lake и MLflow.
Эта презентация из 46 слайдов охватывает: текущие проблемы управления данными, концепцию Data Lakehouse, основу Delta Lake (ACID-транзакции, контрольные точки, медальонная архитектура), функции рабочей области Databricks (кластеры, блокноты, задания, репозитории, модели, Delta Live Tables, AutoLoader), управление данными с помощью Unity Catalog и Delta Sharing, рабочую область ML и MLOps, а также рабочую область SQL Analytics (запросы, панели мониторинга, оповещения).
Эта презентация предназначена для инженеров данных, специалистов по data science, аналитиков данных и технических руководителей, которые хотят понять платформу Databricks. Она служит как инструментом для стимулирования продаж, так и образовательным ресурсом для адаптации команд, оценивающих или внедряющих Databricks.
Презентация включает в себя прямое сравнение, показывающее, что современная архитектура данных требует нескольких отдельных инструментов (Fivetran, Airflow, dbt, Snowflake, Looker, Tableau), в то время как экосистема Databricks объединяет их в единую платформу с Auto Ingest, Delta + Spark, Delta Live Tables и Databricks SQL.
Delta Lake — это уровень хранения с открытым исходным кодом, который обеспечивает ACID-транзакции, масштабируемую обработку метаданных и унифицированную пакетную/потоковую обработку для data lake. Он обеспечивает в 48 раз более быструю обработку данных с помощью индексации, перемещение во времени для управления версиями данных, принудительное применение схемы и детальный контроль доступа, что делает data lake такими же надежными, как data warehouse.
Да, презентация включает в себя подлинные скриншоты пользовательского интерфейса Databricks для кластеров, блокнотов, AutoLoader, заданий, Delta Live Tables, репозиториев, MLflow Model Registry, SQL-запросов, панелей мониторинга, оповещений, истории запросов и Unity Catalog, что обеспечивает реалистичное представление о работе платформы.
Да, файл PPTX полностью редактируется. Вы можете обновить данные, добавить контекст своей компании, изменить архитектурные диаграммы и настроить контент для своей конкретной аудитории — будь то для демонстраций продаж, внутреннего обучения или технических презентаций.
Databricks является мультиоблачной платформой и работает с Microsoft Azure, AWS и Google Cloud. В презентации эта мультиоблачная возможность выделяется как ключевое преимущество, при этом ваши данные хранятся в вашем собственном облачном data lake с использованием открытых форматов.

Create Your Own Slides
Turn your ideas into professional presentations in seconds with 2slides AI.
Используйте профессиональные дизайны, выберите свой стиль и генерируйте слайды с идеальной отрисовкой текста. На базе Nano Banana—начните создавать свою презентацию прямо сейчас.
Your AI Agent for slides. Save time, shine faster with intelligent presentation creation.


© 2026 2slides. All rights reserved.