
Wprowadzenie do platformy Databricks — wszystkie Twoje dane, analityka i AI na jednej platformie
Szybka Nawigacja
Tagi
Udostępnij slajdy
Wprowadzenie do platformy Databricks — wszystkie Twoje dane, analityka i AI na jednej platformie
Szczegółowy widok każdej strony slajdu, w tym układu, kluczowej treści i elementów wizualnych.
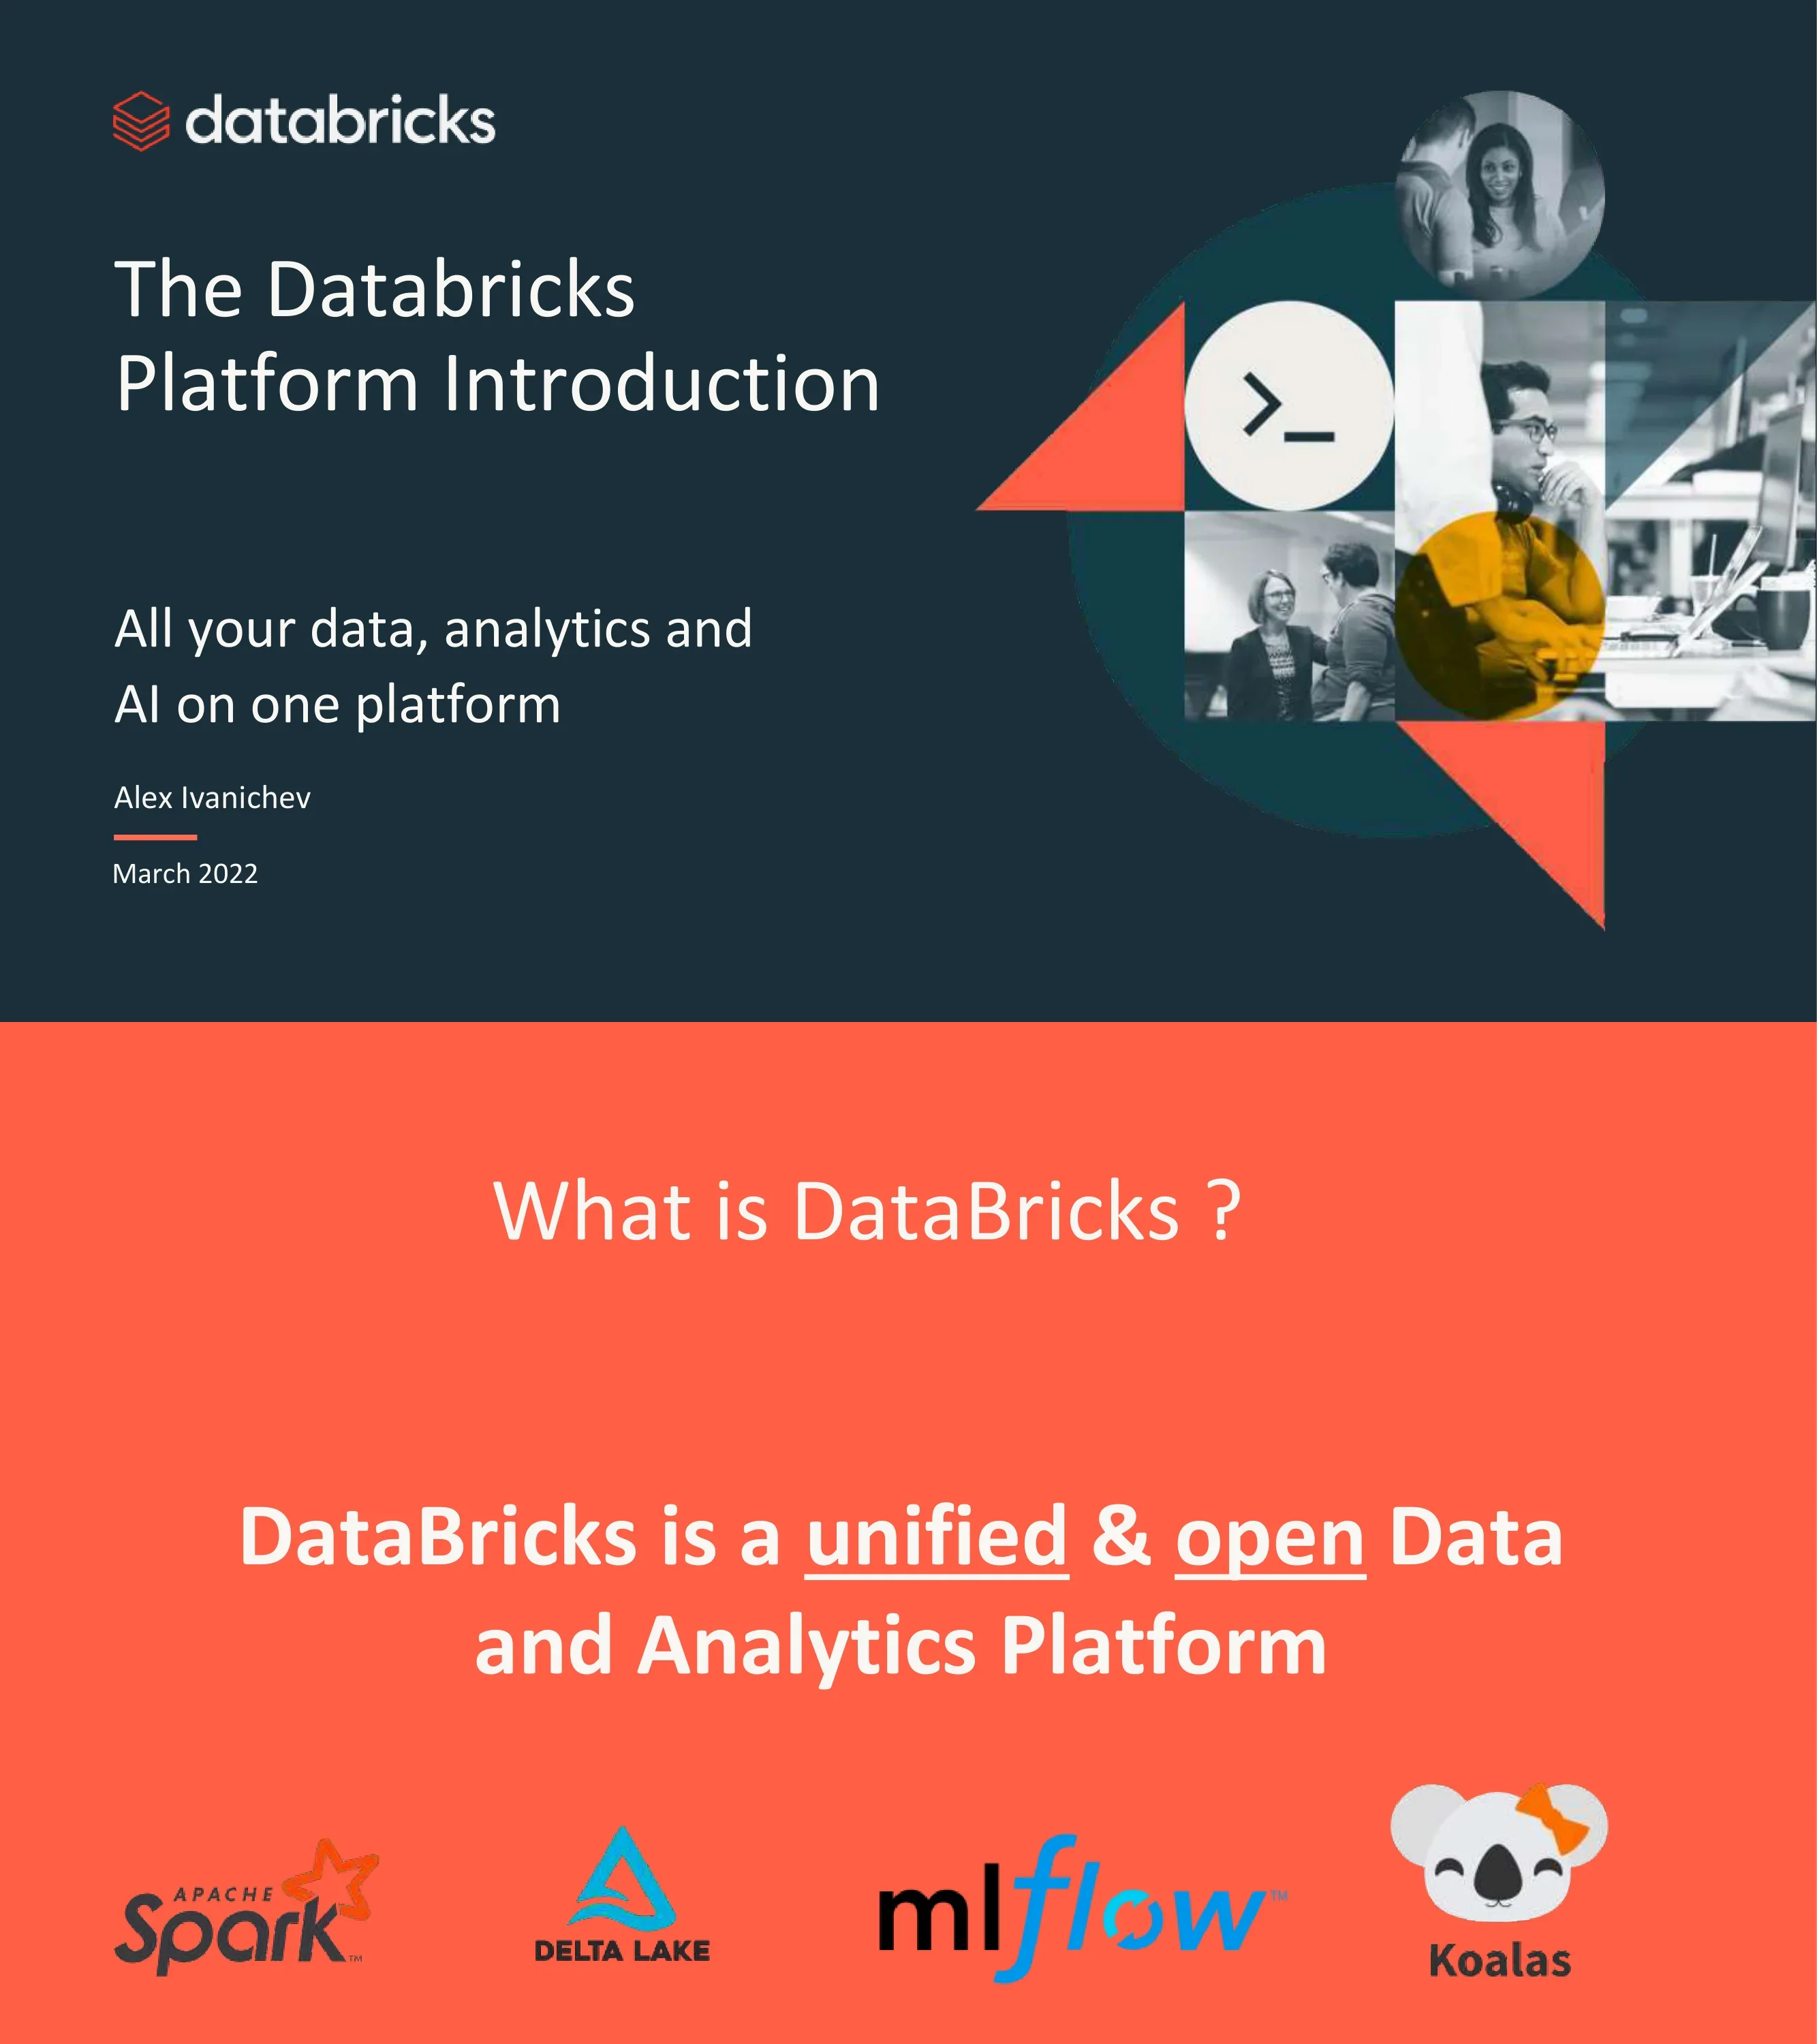
Slajd tytułowy — Wszystkie Twoje dane, analityka i AI na jednej platformie. Autor: Alex Ivanichev, Marzec 2022
Tytuł wyrównany do lewej z autorem/datą, geometryczny kolaż zdjęć po prawej
DataBricks to ujednolicona i otwarta platforma danych i analityki. Zbudowana na open-source: Apache Spark, Delta Lake, MLflow i Koalas
Wyśrodkowany tekst na koralowym tle z czterema logotypami OSS na dole
Wizualny element zastępczy nawigacji przedstawiający kluczowe sekcje prezentacji
Prosty układ agendy
Podział sekcji wprowadzający obecny stan wyzwań związanych z zarządzaniem danymi
Wyśrodkowany biały tekst na zielonym tle
Trzy odizolowane stosy — hurtownia danych, inżynieria danych, Data Science/ML — z odłączonymi systemami i zastrzeżonymi formatami. Pokazuje przepływy ETL między hurtownią danych, Data Lake, przesyłaniem strumieniowym i potokami ML
Nagłówek z trzema kolumnami z diagramem przepływu architektury poniżej
Diagram trójkąta przedstawiający trzy kluczowe role we współczesnych zespołach ds. danych: Analitycy Danych, Inżynierowie Danych i Data Scientists
Wyśrodkowany trójkąt z ikonami ról w każdym wierzchołku
Wizualne porównanie hurtowni danych (dane ustrukturyzowane, ikona bazy danych) z Data Lake (dane nieustrukturyzowane, ikona fal)
Dwie duże ikony obok siebie z etykietami
Trzy wymiary złożoności: dwie oddzielne kopie danych (własnościowe vs. otwarte), niekompatybilne interfejsy (SQL vs Python), niekompatybilne modele bezpieczeństwa/zarządzania (Tabele vs Pliki)
Trzy wiersze porównawcze z kolumnami hurtowni vs. Data Lake
Jedna platforma do ujednolicenia wszystkich danych, analityki i obciążeń AI. Łączy hurtownię danych i Data Lake w jedną warstwę obsługującą Streaming Analytics, BI, Data Science i Machine Learning
Wyśrodkowany diagram architektury z przepływem danych zarówno z hurtowni, jak i Data Lake do ujednoliconej warstwy
Porównanie obok siebie Modern Data Stack (Fivetran → Airflow → dbt → Snowflake → Looker/Tableau) vs Ekosystem Databricks (Fivetran + 100 narzędzi → Object Storage → Auto Ingest → Delta + Spark → Delta Live Tables → Databricks SQL)
Dwukolumnowe pionowe porównanie przepływu
Stos architektury Lakehouse: Cloud Data Lake na dole (Azure, AWS, GCP), otwarty format przechowywania, przetwarzanie danych, bezpieczeństwo/zarządzanie i oparte na rolach doświadczenia na górze. Korzyści: lake-first, natywna obsługa AI/ML, wysoka niezawodność, multi-cloud
Diagram architektury warstwowej po lewej, wypunktowania po prawej
Podział sekcji dla rozdziału Data Lakehouse Foundation
Biały tekst na ciemnym morskim tle z geometrycznymi akcentami
Delta Lake łączy Data Lake i Data Warehouse — otwarte podejście do zarządzania danymi i nadzoru. Kluczowe korzyści: lepsza niezawodność dzięki transakcjom, 48x szybsze przetwarzanie dzięki indeksowaniu, precyzyjna kontrola dostępu
Układ trzykolumnowy: ikona Data Lake | logo Delta Lake + korzyści | ikona Data Warehouse
Projekt open source dla architektury Lakehouse na jeziorach danych. Warstwa przechowywania z transakcjami ACID dla Spark. Kluczowe cechy: Transakcje ACID, Skalowalne Metadane, Podróże w czasie (Time Travel), Otwarty Format, Kanał zmian danych (Change Data Feed), Ujednolicone Przetwarzanie Batch/Strumieniowe, Wymuszanie/Ewolucja Schematu, Historia Audytu
Tytuł z wypunktowaniami w dwóch kolumnach
Trzy rozwiązane wyzwania: Niezawodność i Jakość → transakcje ACID, Wydajność i Opóźnienia → Zaawansowane indeksowanie i buforowanie, Nadzór → Nadzór z Katalogami Danych
Trzy wiersze ze strzałkami od wyzwania do rozwiązania
Struktura dziennika transakcji: Dodaj Plik, Usuń Plik, Aktualizuj Metadane, Ustaw Transakcję, Zmień Protokół, Zatwierdź Informacje. Pokazuje katalog _delta_log z commitami JSON i operacjami dodawania/usuwania plików parquet
Lista punktowana na górze, dwa panele z kodem/diagramem poniżej
Delta Lake generuje pliki checkpoint co 10 commitów w formacie Parquet. Pokazuje strukturę pliku checkpoint, mechanizm listFrom version i obsługę współbieżnego odczytu/zapisu z optymistyczną współbieżnością
Dwa panele diagramów pokazujące strukturę plików i przepływ odczytu/zapisu
Architektura medalionowa Bronze-Silver-Gold: Bronze (surowe pozyskiwanie/historia) → Silver (filtrowane, oczyszczone, rozszerzone) → Gold (agregaty na poziomie biznesowym). Źródła: Kafka, Kinesis, CSV/JSON, Spark. Konsumenci: Streaming Analytics, BI, Data Science/ML
Przepływ danych od lewej do prawej z trzema warstwami bazy danych
Złożony diagram potoku danych z prawdziwego świata, pokazujący splątane zależności między wieloma źródłami, etapami przetwarzania i konsumentami. Utrzymanie jakości i niezawodności w dużej skali jest złożone i kruche
Zagmatwany diagram potoku z wieloma przecinającymi się liniami przerywanymi
Inżynieria Danych na Platformie Databricks Lakehouse: Pozyskiwanie danych → Transformacja danych → Zarządzanie jakością danych → Automatyczne wdrażanie i operacje → Obserwowalność, pochodzenie i widoczność potoku. Planowanie i orkiestracja. Otwarty format przechowywania Delta Lake u podstaw
Warstwowy diagram platformy ze źródłami danych po lewej i konsumentami po prawej
Podział sekcji dla rozdziału dotyczącego funkcji obszaru roboczego
Wyśrodkowany tekst na koralowym tle
Klastry zapewniają zasoby obliczeniowe dla obciążeń Data Analytics, Data Science lub Data Engineering. Pokazuje interfejs użytkownika konfiguracji klastra z Databricks Runtime 7.5 ML, Spark 3.0.1, Community Optimized driver type
Tekst opisu na górze, zrzut ekranu interfejsu użytkownika o pełnej szerokości poniżej
Interfejs internetowy do pisania i wykonywania kodu z uruchamialnymi komórkami dla plików, tabel, wizualizacji i tekstu narracyjnego. Pokazuje notatnik z treścią dotyczącą strategii próbkowania i historią wersji
Tekst opisu na górze, zrzut ekranu notatnika poniżej
Auto Loader przyrostowo przetwarza nowe pliki danych z pamięci masowej w chmurze (GCS, DBFS). Porównanie przed/po: eliminuje złożoną konfigurację Notification Service + Message Queue + Airflow. Zawiera przykład kodu Scala
Opis, diagramy przed/po i fragment kodu
Zadania uruchamiają notatniki zgodnie z harmonogramem dla ETL, Model Building itp. Pokazuje przepływ pracy DAG: Clicks_Ingest → Sessionize + Orders_Ingest → Match → Build_Features → Persist_Features + Train
Tekst opisu na górze, diagram przepływu pracy DAG poniżej
Framework do deklaratywnego definiowania, wdrażania, testowania i uaktualniania potoków danych. Pokazuje interfejs użytkownika potoku DLT z widokiem grafu zależności tabel i dziennikiem zdarzeń
Tekst opisu na górze, zrzut ekranu potoku DLT o pełnej szerokości
Integracja na poziomie repozytorium z GitHub, GitLab, Bitbucket i Azure DevOps. Programiści mogą klonować, zarządzać gałęziami, wypychać/pobierać zmiany bezpośrednio z obszaru roboczego
Tekst opisu na górze, zrzut ekranu interfejsu użytkownika Repos z przeglądarką plików
MLflow Model Registry do zarządzania całym cyklem życia modeli ML. Pokazuje wersjonowanie modeli, przejścia między etapami (Archived, Production, Staging) i oczekujące żądania
Tekst opisu na górze, zrzut ekranu Model Registry z tabelą wersji
Podział sekcji dla rozdziału dotyczącego zarządzania
Wyśrodkowany tekst na koralowym tle
Diagram przedstawiający złożoność: 4 typy danych (Structured, Semi-structured, Unstructured, Streaming) × 3 chmury × oddzielne zasady bezpieczeństwa × wiele kopii wyjściowych
Diagram przepływu od typów danych przez chmury przez zabezpieczenia do wyjść
Przedsiębiorstwa muszą udostępniać i zarządzać różnorodnymi produktami danych: Pliki, Pulpity nawigacyjne, Modele i Tabele
Cztery ikony w rzędzie z etykietami
Centralny katalog, wyszukiwanie i odkrywanie zasobów danych/AI. Ujednolicony model zarządzania w chmurach. Integracja z istniejącymi Enterprise Data Catalogs. Bezpieczne udostępnianie danych na żywo dzięki Delta Sharing
Zrzut ekranu Unity Catalog po lewej, cztery punkty po prawej
Otwarty protokół do bezpiecznego udostępniania danych: Dostawca Danych → Tabela Delta Lake → Serwer Delta Sharing → Protokół Delta Sharing → Odbiorca Danych (Power BI, Tableau, Spark, pandas, Java)
Diagram przepływu od lewej do prawej od dostawcy do odbiorcy
Podział sekcji dla rozdziału o przestrzeni roboczej ML
Wyśrodkowany tekst na zielonym tle
Porównanie obok siebie: Hurtownia Danych (Aplikacje BI → Silnik SQL → Zastrzeżona Pamięć Masowa) vs Data Lakehouse (Aplikacje ML + Aplikacje BI → Python/R + Silnik SQL → Pamięć Masowa w Chmurze z formatami OSS: PNG, UTF-8, Parquet)
Dwa diagramy architektury obok siebie
Wspólne rozwiązanie natywne dla danych dla pełnego cyklu życia ML: Wspólne wielojęzyczne Notebooki → Trenowanie/Dostrajanie modeli, Śledzenie/Rejestr modeli, Udostępnianie/Monitorowanie modeli, Automatyzacja/Zarządzanie → Otwarty wielochmurowy Data Lakehouse i Feature Store
Trójwarstwowy diagram platformy
Cztery wymagania: Dostęp do danych niestrukturalnych (obrazy, tekst, skalowanie do petabajtów), Biblioteki Open Source (TensorFlow, scikit-learn, R), Specjalistyczny sprzęt (GPU, elastyczność chmury), Zarządzanie cyklem życia modelu (artefakty, pochodzenie, produkcja)
Układ czteropolowy z punktami
Business Intelligence (SQL, narzędzia BI, Big Data, Warehouse), Data Science (R, SAS, Python, analiza statystyczna, małe zbiory danych), Machine Learning (Python, deep learning, GPU, duże zbiory danych, dane niestrukturalne). Sekcja ML wyróżniona turkusową obwódką
Porównanie w trzech kolumnach z ikonami ról
ML działa na danych niestrukturalnych, wymaga ogromnych zbiorów danych, używa DataFrames open source (nie SQL), generuje modele (nie raporty) i czasami potrzebuje specjalnego sprzętu (GPU)
Lista punktowana po lewej stronie, duża ikona koła zębatego/osoby po prawej
Otwarte narzędzia do *trenowania* i *obsługi* modeli w lakehouse. Modele to też dane. MLflow dla MLOps: śledzenie/zarządzanie danymi modelu, pochodzeniem, danymi wejściowymi; wdrażanie modeli jako usług lakehouse
Lista punktowana po lewej stronie, ikona ciężarówki dostawczej po prawej
Tabele zarządzają ustrukturyzowanymi danymi wejściowymi modelu, ale brakuje im: pochodzenia upstream, pochodzenia downstream, integracji z wywołującym model i dostępu w czasie rzeczywistym. Feature stores rozwiązują te braki
Lista punktowana po lewej, ikona bazy danych po prawej
Podział sekcji — Wykonuj zapytania do danych data lake za pomocą ANSI SQL z wbudowanym edytorem zapytań, alertami, wizualizacjami i interaktywnymi dashboardami
Wyśrodkowany tekst na zielonym tle z opisem
Edytor zapytań SQL z autouzupełnianiem, przeglądarką tabel i połączeniem z endpointem. Pokazuje zapytanie do zbioru danych NYC taxi z sugestiami kolumn
Tekst opisu na górze, zrzut ekranu edytora zapytań poniżej
Dashboardy SQL łączące wizualizacje: Wygenerowana gotówka ($16M), Liczba sprzedaży (103K), Miesięczny wzrost (13%), Średni koszyk ($154), mapa podsumowania klientów, wykres kwoty na dzień, wykres kołowy kategorii produktów
Zrzut ekranu dashboardu na pełnej szerokości z wieloma typami widżetów
Alerty powiadamiają, gdy wyniki zaplanowanego zapytania osiągną progi. Pokazuje interfejs użytkownika tworzenia alertów, listę alertów ze stanami wyzwolonymi/OK oraz konfigurację alertu ogólnego z miejscami docelowymi (Pops, Platform, Test Webhook)
Tekst opisu na górze, cztery zrzuty ekranu interfejsu użytkownika w siatce
Historia zapytań pokazująca zapytania SQL wykonywane za pośrednictwem SQL endpoints ze szczegółami wykonania: podział czasu trwania (optymalizacja 35%, wykonanie 64%, pobieranie 1%), zwrócone wiersze, odczytane bajty
Opis na górze, pasek boczny + lista zapytań + zrzut ekranu panelu szczegółów
Slajd zamykający z brandingiem Databricks
Prosty tekst z podziękowaniami na ciemnym morskim tle z geometrycznymi kształtami
Częste pytania dotyczące tego slajdu i podstawowej treści prezentacji.
Databricks to ujednolicona i otwarta platforma danych, która łączy najlepsze cechy hurtowni danych i jezior danych w jedną architekturę Lakehouse. Obsługuje inżynierię danych, data science, machine learning i analitykę SQL na jednej platformie, zbudowanej na technologiach open-source, takich jak Apache Spark, Delta Lake i MLflow.
Ten 46-slajdowy deck obejmuje: aktualne wyzwania związane z zarządzaniem danymi, koncepcję Data Lakehouse, fundament Delta Lake (transakcje ACID, punkty kontrolne, architektura medallion), funkcje obszaru roboczego Databricks (klastry, notesy, zadania, repozytoria, modele, Delta Live Tables, AutoLoader), zarządzanie danymi za pomocą Unity Catalog i Delta Sharing, obszar roboczy ML i MLOps oraz obszar roboczy SQL Analytics (zapytania, pulpity nawigacyjne, alerty).
Ta prezentacja jest przeznaczona dla inżynierów danych, data scientists, analityków danych i decydentów technicznych, którzy chcą zrozumieć platformę Databricks. Służy zarówno jako narzędzie wsparcia sprzedaży, jak i zasób edukacyjny dla zespołów oceniających lub wdrażających Databricks.
Prezentacja zawiera bezpośrednie porównanie pokazujące, że nowoczesny stos danych wymaga wielu oddzielnych narzędzi (Fivetran, Airflow, dbt, Snowflake, Looker, Tableau), podczas gdy ekosystem Databricks konsoliduje je w ujednoliconą platformę z Auto Ingest, Delta + Spark, Delta Live Tables i Databricks SQL.
Delta Lake to warstwa przechowywania open-source, która wprowadza transakcje ACID, skalowalne zarządzanie metadanymi i ujednolicone przetwarzanie wsadowe/strumieniowe do jezior danych. Zapewnia 48x szybsze przetwarzanie danych dzięki indeksowaniu, podróż w czasie w celu wersjonowania danych, wymuszanie schematu i szczegółową kontrolę dostępu — dzięki czemu jeziora danych są tak niezawodne jak hurtownie danych.
Tak, prezentacja zawiera autentyczne zrzuty ekranu interfejsu użytkownika Databricks dla klastrów, notesów, AutoLoader, zadań, Delta Live Tables, repozytoriów, MLflow Model Registry, zapytań SQL, pulpitów nawigacyjnych, alertów, historii zapytań i Unity Catalog — zapewniając realistyczny widok doświadczenia platformy.
Tak, plik PPTX jest w pełni edytowalny. Możesz aktualizować dane, dodawać kontekst swojej firmy, modyfikować diagramy architektury i dostosowywać zawartość do konkretnej grupy odbiorców — niezależnie od tego, czy chodzi o demonstracje sprzedaży, szkolenia wewnętrzne czy prezentacje techniczne.
Databricks jest multi-cloud i współpracuje z Microsoft Azure, AWS i Google Cloud. Prezentacja podkreśla tę możliwość multi-cloud jako kluczową zaletę, a Twoje dane są przechowywane we własnym jeziorze danych w chmurze przy użyciu otwartych formatów.

Create Your Own Slides
Turn your ideas into professional presentations in seconds with 2slides AI.
Odwołuj się do profesjonalnych projektów, wybierz swój styl i generuj slajdy z idealnym renderowaniem tekstu. Napędzane przez Nano Banana—zacznij tworzyć swoją prezentację teraz.
Your AI Agent for slides. Save time, shine faster with intelligent presentation creation.


© 2026 2slides. All rights reserved.